
Cómo funcionan las alertas
Las reglas útiles están activas justo después de la instalación; nada necesita ajustes. Lo que marca la diferencia en el uso diario es lo que mantiene bajo el ruido: supresión por dependencia, agrupación por host, ventanas de mantenimiento, y una referencia que aprende antes de hablar.
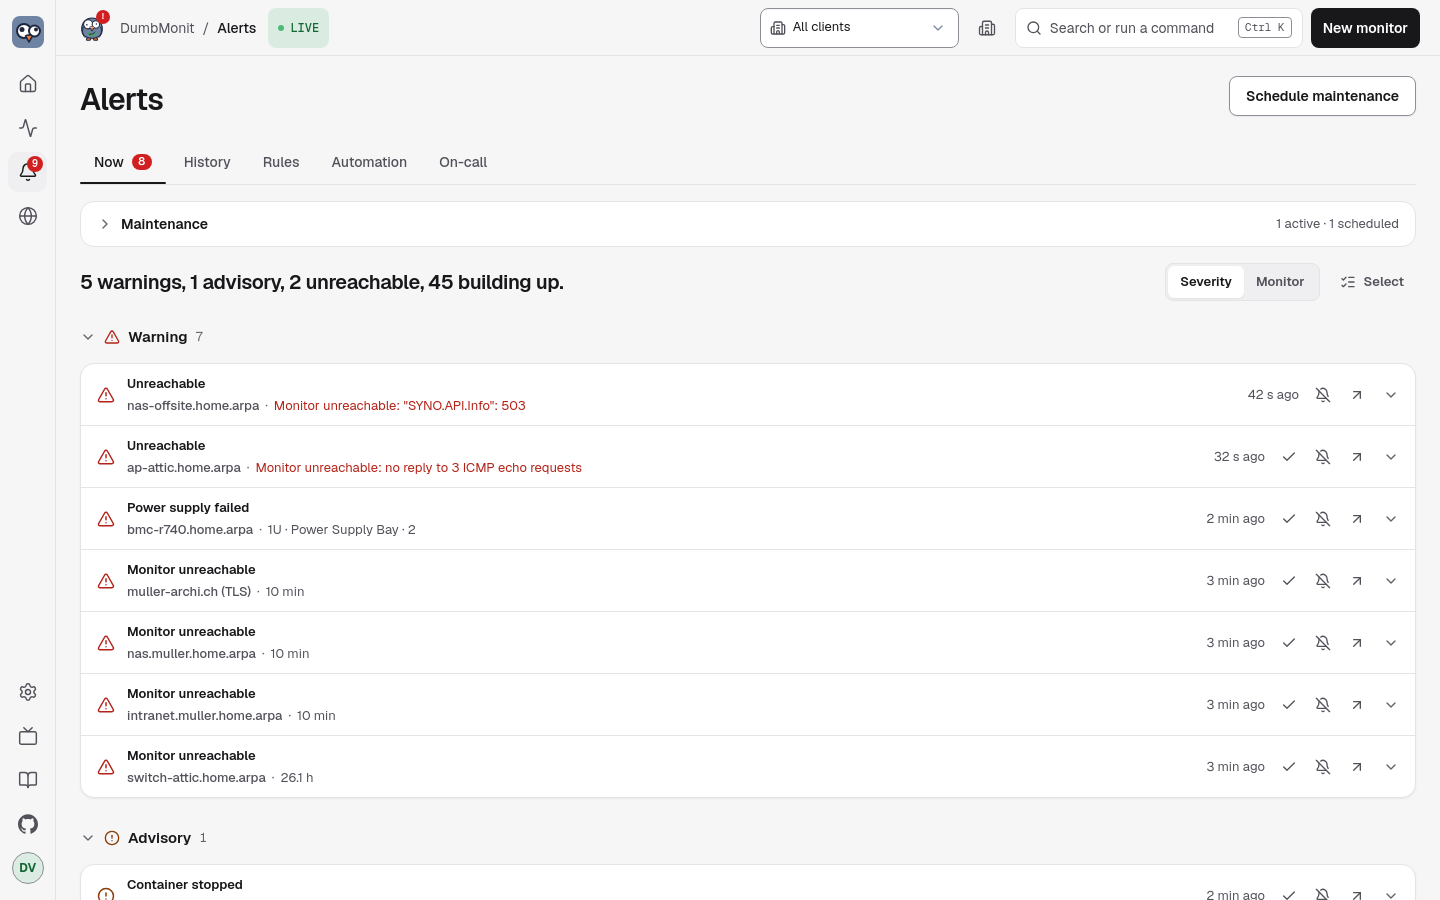
Severidades
Sección titulada «Severidades»La interfaz habla la escala del boletín meteorológico. La API y el editor de reglas guardan los mismos tres niveles bajo sus nombres de motor.
| En la UI | En la API (severity) | Significado |
|---|---|---|
| Info | info | Vale la pena saberlo, no se espera ninguna acción. Usado por la regla de referencia. |
| Advisory | warning | Necesita atención pronto: CPU alta, disco casi lleno, servicio lento. |
| Warning | critical | Te necesita ahora: monitor inaccesible, servicio caído, verificación de copia de seguridad fallida, certificado caducado. |
La escalada eleva la severidad de una regla un escalón tras
escalate_after si la alerta sigue activa (Info → Advisory → Warning;
Warning se mantiene).
Cada alerta es una máquina de estados, evaluada cada 30 segundos
(DUMBMONIT_ALERT_INTERVAL_SECS).
| Fase | En la UI | Significado |
|---|---|---|
ok | — | La condición es falsa. |
pending | Building up | La condición es verdadera pero el tiempo de espera de la regla (for) aún no ha transcurrido. No se envía nada. |
firing | Firing | La condición se ha mantenido el tiempo suficiente. Se envía la primera notificación, luego recordatorios cada repeat_interval (6 horas por defecto para la mayoría de reglas integradas), luego una escalada si está configurada. |
resolved | Resolved | Vuelta a la normalidad. Una notificación de resolución se envía solo si la activación había sido anunciada. |
suppressed | Suppressed by parent | La alerta está activa, pero un monitor padre está caído, o el propio monitor es inaccesible: consulta abajo. |
phase es el estado del motor; effective_phase es lo que lees. Una
alerta cuyo effective_phase es suppressed conserva phase = firing
por debajo, así que no se notifica de nuevo cuando el padre se
recupera.
Una alerta también puede ser confirmada (acked, con acked_by,
acked_until y ack_note): la fase no se mueve, los recordatorios y
escaladas se pausan hasta acked_until, la resolución igual se
notifica y borra la confirmación. Aplazar una alerta funciona igual
por debajo pero a través de una ventana de mantenimiento limitada a las
etiquetas exactas de esa alerta (silenced: true), en lugar de todo el
monitor: una regla hermana en el mismo monitor sigue hablando.
Consulta Deshacerse de una alerta.
Supresión por dependencia
Sección titulada «Supresión por dependencia»Cualquier monitor puede declarar un monitor padre. Cuando un monitor está
caído, cada alerta en sus descendientes se marca Suppressed by parent en
lugar de enviarse: un switch que se cae produce una notificación, no treinta.
El ancestro caído más cercano se nombra como la causa (suppressed_by), y la
cadena se sigue hasta 64 niveles.
Un monitor está caído cuando una de estas alertas se activa en él, sea cual sea la causa:
- Monitor unreachable: ninguna medición en absoluto (un dispositivo SNMP que dejó de responder, un agente que dejó de enviar);
- Service down: su comprobación de disponibilidad se ejecuta pero falla (un ping con 100 % de pérdida, una comprobación HTTP que da error o agota el tiempo, un puerto TCP cerrado, etc.).
Una simple advertencia en el padre (disco lleno, CPU alta, servicio lento, un certificado a punto de caducar) no oculta nada: el dispositivo sigue respondiendo, y lo que hay detrás también. El padre conserva su propia alerta y su notificación; cuando se recupera, los hijos que siguen caídos se activan y notifican por su cuenta.
Lo mismo vale para un monitor inaccesible en sí: sus demás alertas
(disco lleno, CPU, etc.) se suprimen por su propia caída, con suppressed_by
nombrando al propio monitor, ya que sus valores están desactualizados y
solo son un síntoma del mismo fallo. Solo su alerta «Monitor unreachable» nunca
se oculta por su propia caída, así que se te avisa una vez.
Define el padre en el formulario del monitor. En la página Devices, los hijos se apilan bajo su padre y se atenúan cuando está caído.
Un agente relay cuenta como padre de cada monitor que sondea (Reached through en el formulario del monitor), además del padre definido explícitamente: cuando el relay está caído, sus monitores se suprimen con el relay nombrado como la causa. A igual distancia, el padre explícito gana.
Un padre también cuenta como caído en cuanto su propia sonda lo indica (el estado Timed out, Monitor unreachable o Service down en su página), sin esperar a que su alerta se active: un agente que deja de enviar se lleva consigo a sus monitores un minuto o dos antes de su propia alerta, y un switch cuyo ping acaba de fallar oculta a sus hijos antes de que termine la espera de «Service down»; de otro modo cada uno notificaría primero.
Agrupación, deduplicación, recordatorios
Sección titulada «Agrupación, deduplicación, recordatorios»Sin agrupación, un NAS cuyo RAID se degrada enviaría un mensaje por
disco, por ciclo. DumbMonit envía como máximo un mensaje por host y por
ciclo, incluso si contiene cinco líneas. Cada alerta se notifica una vez
cuando se activa (firing), luego solo como recordatorio (reminder,
cada repeat_interval), una escalada (escalation) o una resolución
(resolved). El historial de alertas registra cada transición con si se
notificó y, si no, por qué (aprendizaje, suprimida, silenciada,
confirmada).
Ventanas de mantenimiento
Sección titulada «Ventanas de mantenimiento»Un silencio detiene las notificaciones sin detener la evaluación: al final de una ventana, una alerta que todavía está activa se notifica una vez, en lugar de «nacer» tras dos horas de existencia. Las ventanas son puntuales o semanales, por monitor o para toda la instancia. Consulta Ventanas de mantenimiento.
Aprendizaje de referencia
Sección titulada «Aprendizaje de referencia»La regla «Unusual CPU» no necesita ningún umbral. Para cada serie
mantiene 168 cubos, uno por (día de la semana, hora), y compara cada
punto con lo que se observa habitualmente en ese momento. La
puntuación es robusta (mediana y MAD, un EWMA por cubo con alpha = 0.05), así que un único incidente no reescribe la referencia, y se
siguen las derivas estacionales.
La regla permanece en silencio durante sus primeros catorce días de aprendizaje: cada cubo debe haberse visto al menos dos veces para distinguir «inusual» de «nunca observado». Entretanto se muestra con una marca de learning y solo indica lo que habría activado. Las referencias de series que desaparecieron se olvidan tras 60 días.
Pronósticos
Sección titulada «Pronósticos»Dos tipos de alerta predicen en lugar de reportar, y el resumen los
lista bajo Forecasts: la anomalía de referencia, y las reglas
predict que extrapolan una serie con predict_linear() del lado de
VictoriaMetrics («Filesystem almost full» dentro de cuatro días). La
estimación del datastore de PBS es un umbral sencillo sobre el propio
pronóstico de PBS.
Dónde van las notificaciones
Sección titulada «Dónde van las notificaciones»Las reglas integradas no tienen ningún canal asignado, lo cual significa cada canal activado. Una regla que edites puede nombrar canales específicos. Los canales se configuran en Alerts → Notifications; consulta Canales de notificación.
Notificaciones inteligentes
Sección titulada «Notificaciones inteligentes»Todo lo anterior decide si una alerta puede hablar. Una segunda etapa, la política de notificación, decide cuándo y en qué canal, para que nadie reciba spam. El camino completo de una alerta, en orden:
- Evaluar — umbral, puntuación de anomalía o pronóstico, con el
tiempo de espera de la regla (
for) y, cuando se define, su umbral de limpieza (histéresis: activar por encima del 90 %, limpiar solo por debajo del 85 %) y cualquier anulación por monitor. - Deduplicar — una huella por (regla, serie), con clave en el id
del monitor (
target) en lugar de su nombre: renombrar un monitor o editar sus etiquetas no crea una segunda alerta, y una serie que resuelve a la misma clave dos veces produce una alerta. Las series de un monitor eliminado o pausado se descartan: sus alertas se limpian de inmediato, sin ninguna notificación, y el historial registradevice removed or disabled. - Suprimir por dependencia — los descendientes de un monitor caído permanecen en silencio.
- Silenciar — las ventanas de mantenimiento silencian lo que cubren.
- Agrupar por monitor — un mensaje por monitor por ciclo, recordatorios y escalada incluidos.
- Retención de parpadeo — una huella que se activa y limpia 4 veces en 30 minutos envía un único aviso de «flapping», y luego nada durante 30 minutos.
- Filtros por canal — severidad mínima, «avísame cuando se limpie» activado/desactivado, y un intervalo mínimo entre dos mensajes sobre la misma alerta.
- Horas de silencio (por canal) — solo pasan las alertas de nivel Warning; el resto espera a un resumen cuando terminan las horas de silencio (una alerta que se limpia entretanto solo se menciona como «resolved during quiet hours»).
- Agrupamiento por lotes — las alertas dentro de la ventana de lote (60 s por defecto) salen como un mensaje por canal: «3 alerts on 2 devices, 1 resolved».
- Límite por hora — más allá de
max_per_hourmensajes en un canal, las alertas esperan y llegan como un resumen («…and 7 more alerts»). - Enviar — con un enlace «Open in DumbMonit» por monitor cuando se conoce una URL pública.
Los pasos 6 a 10 se configuran en Settings → Notifications & reports → Notification policy (global) y en cada canal (Delivery options). Consulta Política de notificación.