
Proxmox VE
Гипервизор: узлы с их демонами и сетью, виртуальные машины, контейнеры, хранилища, пулы LVM thin, резервные копии, высокая доступность, снапшоты, репликация, Ceph вплоть до OSD, физические диски и пулы ZFS, ожидающие обновления, изменения пакетов, подписка и сертификаты. Один монитор может охватывать весь кластер.
Панель узлов
Заголовок раздела «Панель узлов»Страница монитора открывается карточкой на каждый узел: CPU, память и корневая файловая система в виде
трёх индикаторов, время работы и версия pve-manager, установленная на этом узле,
затем только то, что не в порядке, — демоны, которые не запущены, интерфейсы,
объявленные при загрузке, но не поднятые, — и заполненность каждого пула LVM thin и
группы томов. Узел, переставший отвечать, сохраняет свою карточку со статусом offline.
Две строки под индикаторами, когда узел их сообщает: доля процессорного времени, потраченная на ожидание хранилища (I/O wait — узел с 10 % CPU и 30 % I/O wait не имеет запаса, и никакое другое число об этом не говорит), и память, которую KSM вернул, объединив одинаковые страницы между гостями, — именно так узел размещает больше, чем у него есть RAM.
В список «что не в порядке» добавляются ещё две записи, обе словами:
- Reboot required — установлено ядро новее, чем запущенное. Карточка
называет обе версии, так как узел продолжает работать на старом, пока он не будет
перезагружен. Это берётся из
/nodes/{node}/apt/versions, для чего нужен толькоSys.Audit; - Updates pending — сколько пакетов Proxmox имеют более новую версию-кандидата,
из того же вызова. Это не то же самое, что
apt/update, который считает все ожидающие пакеты системы, но требуетSys.Modifyи обычно отклоняется.
Когда кластер сообщает о HA watchdog (Proxmox VE 9 и новее), его состояние указывается рядом с заголовком панели: HA fencing armed, как только ресурсы переданы в HA, HA fencing standby, пока их нет, — в этом случае ни один узел не будет изолирован (fenced), что нормально, но стоит знать, прежде чем на это рассчитывать.
Кластер, обновляемый узел за узлом, показывает это здесь: /version отвечает за тот
узел, к которому обратились, поэтому каждая карточка несёт собственную версию, и отстающий
виден без открытия оболочки.
Данные поступают из GET /api/targets/{id}/proxmox/nodes, читаются из последнего
опроса в хранилище метрик.
Панель гостей
Заголовок раздела «Панель гостей»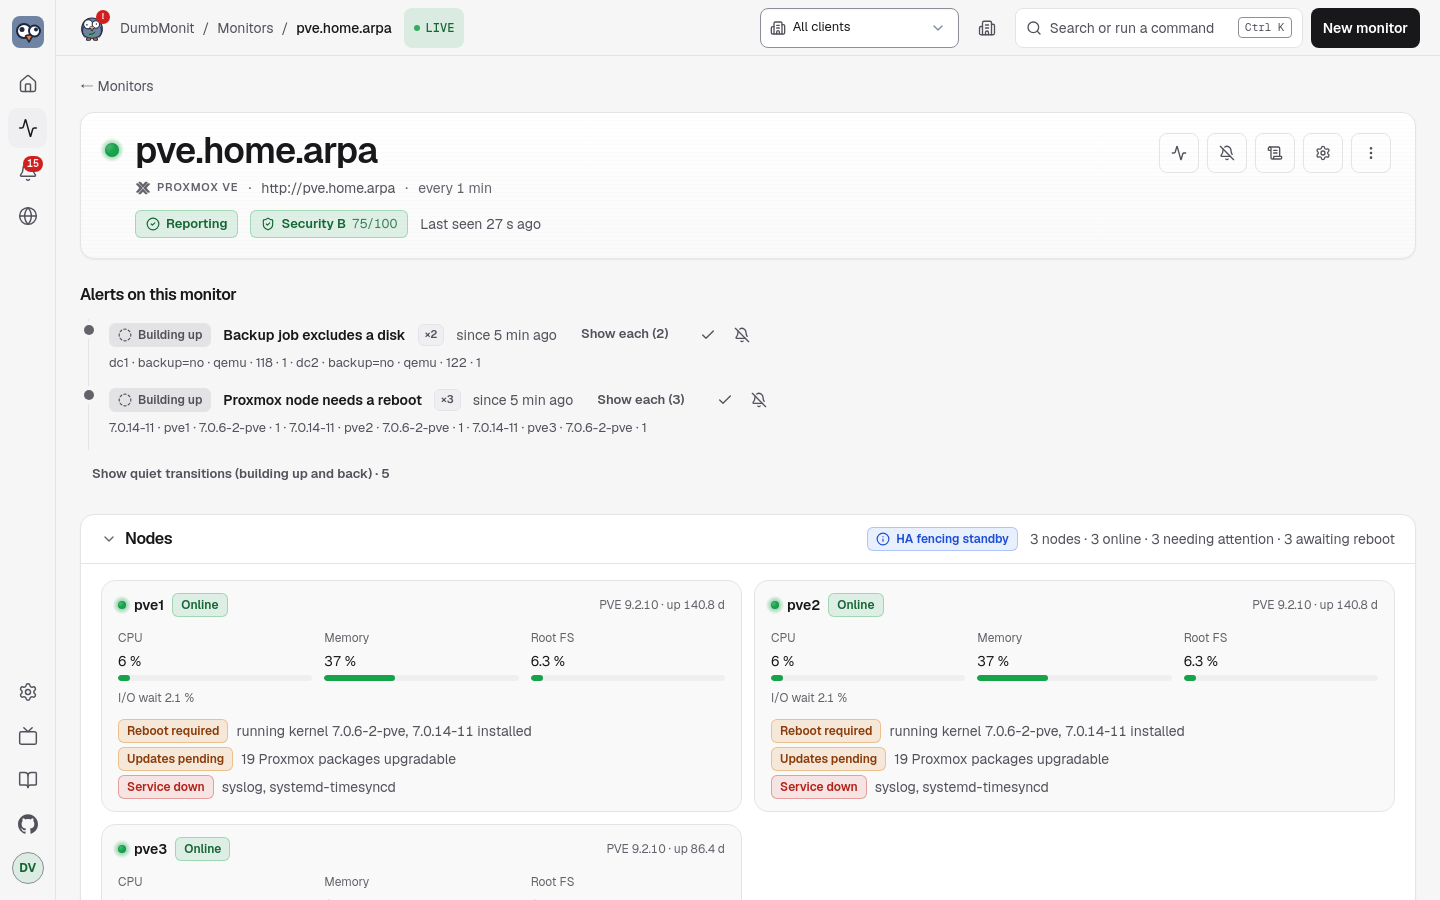
Под узлами находится панель Guests: одна строка на каждую виртуальную машину и контейнер, сгруппированные по узлам, отвечающая на вопросы, которые администратор задаёт первыми, — запущен ли гость, загружен ли он, заполнен ли его диск, когда была последняя резервная копия. Каждая строка показывает:
| Столбец | Источник | Примечания |
|---|---|---|
| Status | слово + плашка: running, stopped, paused, suspended, template | Шаблон отображается в списке, но никогда не считается «stopped». |
| Name, VMID, node | инвентарь | |
| CPU | guest_cpu_percent, от ядер, выделенных гостю | Полоса плюс число ядер. |
| Memory | guest_memory_used_bytes / guest_memory_total_bytes | Размер баллона, если он есть у ВМ. Вторая строка, +N on host, появляется, когда guest_memory_host_bytes заметно выше того, что видит гость: процесс QEMU обходится гипервизору дороже, чем память, которую он выдаёт, и этот излишек — накладные расходы эмуляции. Ниже 64 МиБ или 5 % строка не показывается. |
| Disk | guest_disk_used_bytes / guest_disk_total_bytes | Контейнеры: реальное использование. ВМ: размер всегда; использование только когда отвечает гостевой агент QEMU (см. ниже), иначе «size only». |
| Network | rate(guest_network_in/out_bytes) за последние опросы | |
| Uptime | guest_uptime_seconds | |
| Last backup | backup_last_age_seconds | Пусто, если резервных копий не известно. |
| HA | ha_resource_state_info | Только для гостей под высокой доступностью. |
| Lock | guest_locked | Значок, только пока удерживается блокировка (backup, migrate, snapshot…). |
Список сортируется по любому столбцу, фильтруется по узлу, статусу или пулу, а каждая группа
узла сворачивается. Щелчок по строке открывает CPU и память за временной диапазон
страницы, а также операционную систему и IP-адреса, видимые изнутри
гостя. Данные поступают из GET /api/targets/{id}/proxmox/guests, который
читает последний опрос из хранилища метрик — у гипервизора ничего не запрашивается.
Блокировка нормальна в течение тех нескольких минут, которые занимает резервное копирование, миграция или
снапшот. Если её оставило прерванное задание, она блокирует любую операцию с этим
гостем — включая резервную копию следующей ночи — пока qm unlock (или pct unlock) её не снимет, поэтому «Guest locked» срабатывает через шесть часов.
Инвентарь берётся из /cluster/resources, собственного кэша кластера, поэтому
гости узла, переставшего отвечать, по-прежнему перечислены — со статусом
unknown и своими размерами, но без живых измерений, — вместо того чтобы исчезнуть
с панели в тот момент, когда вы хотите на них посмотреть. Это также обходится на два вызова API
дешевле на узел, чем обход /nodes/{node}/qemu и /nodes/{node}/lxc,
к чему возвращается опция cluster_resources при отключении.
Использование диска внутри ВМ: гостевой агент QEMU
Заголовок раздела «Использование диска внутри ВМ: гостевой агент QEMU»Proxmox видит диск ВМ как непрозрачный том: disk для ВМ всегда равен 0,
известен только его размер. Чтобы прочитать использование изнутри, коллектор запрашивает
у гостевого агента QEMU (agent/get-fsinfo) данные для каждой запущенной ВМ, в конфигурации которой
агент включён (Options → QEMU Guest Agent). Два условия:
qemu-guest-agentустановлен и запущен внутри ВМ (Debian и Ubuntu:apt install qemu-guest-agent; Windows: ISO с драйверами VirtIO);- токен имеет
VM.GuestAgent.Auditна ВМ —VM.Monitorдо Proxmox VE 9 (рольDumbMonitниже выдаёт его на/).
Корневая файловая система (/, или C:\ в Windows; если её нет, самая большая)
даёт guest_disk_used_bytes и guest_disk_used_percent, те же ряды, что
у контейнера, поэтому правило «VM or container disk almost full» покрывает оба случая.
Каждая реальная файловая система также получает guest_fs_total/used_bytes и
guest_fs_used_percent с меткой mountpoint; псевдофайловые системы (tmpfs,
squashfs, монтирования snap) и носители без ёмкости пропускаются.
guest_agent_enabled показывает, включён ли агент в конфигурации ВМ,
guest_agent_running — ответил ли он. Без агента или права
ВМ сохраняет свой размер и просто не имеет использования — никогда не вводящих в заблуждение «0 %».
Операционная система и адреса гостя
Заголовок раздела «Операционная система и адреса гостя»Proxmox знает только тип ОС, записанный в конфигурации гостя (l26,
win11), а не то, что реально работает. При включённой опции guest_os коллектор
спрашивает каждого запущенного гостя, что он такое: agent/get-osinfo и
agent/network-get-interfaces для ВМ, /nodes/{node}/lxc/{vmid}/interfaces
для контейнера, для чего внутри ничего устанавливать не нужно. Это даёт
guest_os_info (Debian GNU/Linux 12 (bookworm), её id, версия, ядро)
и до четырёх guest_ip_info — адреса loopback и IPv6 link-local
пропускаются, а машина с десятками виртуальных интерфейсов не
засоряет базу рядов.
Оба запрашиваются не чаще раза в час на гостя и между запросами публикуются заново из памяти: операционная система не меняется между двумя опросами, а адрес почти никогда. На кластере из пятидесяти запущенных машин это разница между двумя дополнительными вызовами на опрос и двумя в час.
Эти два вызова агента требуют VM.GuestAgent.Audit. В Proxmox VE 7 его не было,
и использовался VM.Monitor; Proxmox VE 9 убрал VM.Monitor и оставляет только
привилегии гостевого агента. Без той, которую знает ваша версия, оба ряда
просто отсутствуют; больше ничего не меняется.
Панель Ceph
Заголовок раздела «Панель Ceph»Раздел Ceph появляется на странице монитора, только когда в кластере действительно есть Ceph: состояние здоровья и слова за ним, общая и использованная ёмкость, сколько OSD up и in, таблица OSD (хост, класс устройства, использование, задержки apply и commit) и таблица пулов (использование, size и min size, placement groups относительно числа, которое выбрал бы autoscaler), файловые системы CephFS, оставленные установленными флаги OSD и текущие заглушённые проверки здоровья.
Последние два — то, что панель мониторинга обычно скрывает. noout, установленный на время
обслуживания и никогда не снятый, означает, что Ceph больше не будет перебалансировать данные из-за мёртвого OSD,
а заглушённая проверка больше не отображается в HEALTH_OK — в обоих случаях
кластер выглядит здоровым, пока его избыточность тихо исчезает.
GET /api/targets/{id}/proxmox/ceph отвечает available: false, когда в
кластере нет Ceph, по этому признаку UI знает, что раздел рисовать не нужно.
Детализация стоит три вызова на одном узле плюс два на весь кластер, независимо от
размера кластера, и требует опции ceph_detail поверх
ceph.
За чем он следит
Заголовок раздела «За чем он следит»Все метрики имеют префикс dumbmonit_proxmox_.
| Семейство | Метрики | Метки |
|---|---|---|
| Cluster | cluster_quorate, cluster_nodes, cluster_nodes_online, cluster_member_online; version_info (+ version, release, repoid) | cluster, node |
| Cluster inventory | cluster_guests_total, cluster_guests_running, cluster_templates_total (шаблоны считаются отдельно, никогда как «stopped»); pool_guests, по одной на каждый пул ресурсов | pool |
| Nodes | node_up, node_cpu_percent, node_cpu_count, node_load1/5/15, node_memory_used/total_bytes, node_memory_percent, node_swap_used/total_bytes, node_rootfs_used/total/avail_bytes, node_rootfs_percent, node_cpu_iowait_percent (время ожидания дисков — узел с 10% CPU и 30% iowait не имеет запаса), node_ksm_shared_bytes (память, возвращённая дедупликацией страниц), node_uptime_seconds, node_version_info | node |
| Node services | node_service_running, node_service_state_info (+ state), node_services_failed, node_core_services_down; node_pve_version_info (+ version, release) для узла, который ответил | node, service |
| Node network | node_interface_active, node_interface_exists, node_interface_autostart, node_interface_mtu, node_interface_offline; итог node_interfaces_offline | node, iface, type (bridge, bond, vlan, eth…) |
| LVM, thin pools and mounts | node_lvm_vg_size/free_bytes, node_lvm_vg_used_percent, node_lvm_vg_physical_volumes (метка vg); node_thinpool_size_bytes, node_thinpool_used_bytes, node_thinpool_used_percent, node_thinpool_metadata_size_bytes, node_thinpool_metadata_used_percent (метки vg, pool); node_directory_mount_info (+ path, device, fstype), node_directory_mounts | node, vg, pool |
| Guests (VMs and containers) | guest_status_info (+ status: running, stopped, paused, suspended, template), guest_running (не для шаблонов), guest_cpu_percent (от выделенных ядер), guest_cpu_count, guest_memory_used/total_bytes, guest_memory_host_bytes (Proxmox VE 9: память, которую ВМ занимает на хосте, включая накладные расходы эмуляции), guest_memory_percent (с собственной точки зрения гостя; в Proxmox VE 9 берётся из драйвера баллона, а у ВМ без него есть байты, но нет процента, вместо значения выше 100%), guest_disk_total_bytes, guest_disk_used_bytes и guest_disk_used_percent (контейнеры; ВМ только через гостевой агент), guest_disk_read/write_bytes, guest_network_in/out_bytes (счётчики), guest_uptime_seconds; guest_pool_info (+ pool), guest_locked (+ lock; ряд существует только пока удерживается блокировка, поэтому её длительность читается прямо с графика) | node, vmid, name, type (qemu или lxc) |
| VM detail (running VMs) | guest_agent_enabled, guest_agent_running, guest_balloon_bytes, guest_memory_guest_free_bytes (свободная память, видимая изнутри, драйвер баллона), guest_running_qemu_info (+ version: QEMU, с которым была запущена ВМ — после обновления гипервизора он остаётся прежним, пока ВМ не будет остановлена и запущена снова, чего живая миграция не делает); для каждой файловой системы guest_fs_total_bytes, guest_fs_used_bytes, guest_fs_used_percent | node, vmid, name, type; файловые системы: + mountpoint, fstype |
| Guest system and addresses | guest_os_info (+ os, os_id, os_version, kernel), guest_ip_info (+ iface, ip; не более четырёх маршрутизируемых адресов на гостя). Обновляется раз в час | node, vmid, name, type |
| Guest network cards | guest_netdev_in_bytes, guest_netdev_out_bytes (счётчики), одна пара на виртуальный интерфейс, тогда как guest_network_in/out_bytes даёт только итог по гостю | node, vmid, dev (tap100i0, veth200i0) |
| Storages | storage_active, storage_enabled, storage_used/total/avail_bytes, storage_used_percent (ёмкость публикуется, только когда Proxmox её сообщает: неактивное хранилище или datastore PBS, размер которого PVE не читает, не получают ни одного значения вместо нулевых байтов) | node, storage, type (dir, lvmthin, zfspool, nfs, pbs…), shared |
| Backups (per guest) | backup_present, backup_last_timestamp_seconds, backup_last_age_seconds, backup_last_size_bytes, backup_count; итоги backup_guests_total, backup_guests_without_backup | vmid, name, node, type |
| Backups (vzdump runs, per node) | backup_job_runs, backup_job_failures, backup_job_last_ok, backup_job_last_timestamp_seconds, backup_job_last_age_seconds, backup_job_last_duration_seconds | node |
| Backup jobs (scheduled) | backup_job_enabled, backup_job_next_run_seconds, backup_job_last_ok, backup_job_last_run_age_seconds (последние две только когда задача vzdump несёт id задания, PVE 7.2+); итоги backup_jobs_total, backup_guests_not_covered; backup_covered на гостя (0 для гостя, не охваченного ни одним заданием) | job, storage, schedule; backup_covered: vmid, name, node, type |
| Backup job coverage | backup_job_guests, backup_job_volumes_included, backup_job_volumes_excluded; backup_job_guest_excluded_volumes (+ vmid, name, type, reason), публикуется только для неожиданного исключения | job |
| HA | ha_quorum_ok, ha_fencing_armed (+ state: Proxmox VE 9 сообщает, находится ли watchdog в состоянии armed или standby — в standby ничто не будет изолировано), ha_master_active, ha_lrm_active (node), ha_resources_total; для каждого ресурса ha_resource_started, ha_resource_error (1 в состоянии error, fence или recovery), ha_resource_state_info (+ state) | sid, node, vmid, type |
| HA manager | ha_node_online, ha_node_status_info (+ status: online, fence, gone, maintenance), ha_master_info (узел, удерживающий мастер CRM), ha_manager_age_seconds; для каждого узла ha_lrm_mode_info (+ mode, state), ha_lrm_age_seconds, ha_lrm_stale (1, когда LRM не писал более двух минут) | node |
| Snapshots | guest_snapshot_count, guest_snapshot_oldest_age_seconds, guest_snapshot_newest_age_seconds (возрасты только при count > 0); guest_snapshot_guests_skipped при превышении max_snapshot_guests | vmid, name, node, type |
| Replication | replication_job_enabled, replication_job_error (сообщение об ошибке или fail_count > 0), replication_job_fail_count, replication_job_last_sync_age_seconds, replication_job_next_sync_seconds, replication_job_duration_seconds; replication_jobs_total | job, vmid, node (источник), to_node |
| Ceph | ceph_health (0 OK, 1 WARN, 2 ERR, 3 неизвестно), ceph_health_info (+ status), ceph_osds_total/up/in, ceph_bytes_total/used, ceph_used_percent, ceph_pgs_total, ceph_mons_total | |
| Ceph OSDs | ceph_osd_up, ceph_osd_in, ceph_osd_used_percent, ceph_osd_used_bytes, ceph_osd_total_bytes, ceph_osd_apply_latency_ms, ceph_osd_commit_latency_ms, ceph_osd_reweight, ceph_osd_crush_weight; итоги ceph_osds_down, ceph_osds_out | osd, ceph_host, device_class |
| Ceph pools and CephFS | ceph_pool_used_percent, ceph_pool_used_bytes, ceph_pool_size, ceph_pool_min_size, ceph_pool_pg_num, ceph_pool_pg_num_optimal (что выбрал бы autoscaler), ceph_pool_info (+ type, crush_rule, autoscale), ceph_pools_total; ceph_fs_info (+ metadata_pool, data_pool), ceph_fs_total | pool; CephFS: name |
| Ceph flags and mutes | ceph_flag (1, пока флаг установлен), ceph_flags_set; ceph_health_mute_info (+ sticky), ceph_health_mutes | flag; заглушки: code |
| Physical disks | node_disk_size_bytes, node_disk_smart_failed (1, когда состояние SMART равно FAILED; отсутствует, когда диск сообщает UNKNOWN), node_disk_health_info (+ health, used: LVM, ZFS, partitions…), node_disk_wearout_percent (SSD и NVMe: 0 — новый, 100 — конец номинального ресурса), node_disk_temperature_celsius (из disks/smart: атрибут ATA 194/190 или строка температуры текстового отчёта — Temperature: для NVMe, Current Drive Temperature: для SAS) | node, disk (/dev/sda, /dev/nvme0n1), model, type (ssd, hdd, nvme) |
| ZFS pools | node_zfs_pool_degraded (1, если не ONLINE), node_zfs_pool_health_info (+ health), node_zfs_pool_size/alloc/free_bytes, node_zfs_pool_used_percent, node_zfs_pool_fragmentation_percent | node, pool |
| Updates | node_updates_pending, node_updates_security_pending (пакеты, чьё происхождение, метка репозитория, suite, раздел или URL журнала изменений указывают на архив безопасности, например bookworm-security у Debian). Без Sys.Modify эти два ряда не существуют; node_pve_packages_upgradable тогда всё равно считает пакеты Proxmox, чья версия-кандидат отличается от установленной, а node_reboot_required (+ running, installed) сообщает, что более новое ядро установлено, но ещё не загружено — оба читаются из apt/versions, для чего нужен только Sys.Audit | node |
| Package changes | node_packages_changed: обычно 0; в течение часа после того, как опрос видит изменение установленной версии пакета Proxmox (apt/versions), число изменившихся пакетов, с меткой changes, например pve-manager 8.2.4→8.2.7, proxmox-kernel-6.8 6.8.8-2→6.8.12-2 | node, changes |
| Subscription and repositories | node_subscription_active, node_subscription_info (+ status: active, notfound, expired…, level, next_due); node_repository_errors (нечитаемые файлы sources), node_repository_warnings (собственные предупреждения Proxmox: репозиторий enterprise без подписки, тестовый репозиторий), node_repository_enabled (+ repo: enterprise, no-subscription, test, ceph-*) | node |
| Certificates | node_certificate_expiry_days (отрицательное после истечения) | node, filename, subject |
| RRD stream (off by default) | node_rrd_<metric>, guest_rrd_<metric>, storage_rrd_<metric> — каждое измерение, которое получают собственные серверы метрик Proxmox, под своим именем (см. metrics_export ниже) | node; гости: vmid, type; хранилища: node, storage |
| Collection | up, scrape_errors, scrape_duration_seconds |
Возраст резервной копии по каждой машине отвечает на самый дорогостоящий сбой домашней лаборатории:
резервная копия, не выполнявшаяся неделями и обнаруженная в день восстановления. Он вычисляется
из журнала задач vzdump (за backup_lookback_days) и, если
включён scan_backup_storage, из архивов, найденных в хранилищах резервных копий.
Запланированные задания берутся из Datacenter → Backup: backup_covered равен 0 для каждого
гостя, который сам Proxmox перечисляет как не охваченный ни одним заданием, поэтому машина, созданная
вчера, появляется до первой пропущенной резервной копии, а не после.
Задание, охватывающее гостя, не обязательно записывает все его диски. Том,
помеченный backup=0, пропускается каждую ночь, задание по-прежнему сообщает об успехе,
и никто не узнаёт об этом до восстановления. backup_job_guest_excluded_volumes называет
задание, гостя и собственную причину Proxmox для исключения — но только когда
исключение неожиданно: привод CD-ROM, образ cloudinit или запись, вообще не
являющаяся томом, исключаются по замыслу, учитываются в
backup_job_volumes_excluded и никогда не сообщаются по гостям. Без этого
различия каждая машина с виртуальным приводом вызывала бы оповещение.
За демонами узла стоит следить по одной причине: остановленный pvestatd ничего
явно не ломает — веб-интерфейс продолжает показывать числа на
момент его смерти, и всё выглядит нормально. node_core_services_down считает
только pve-cluster, pvedaemon, pveproxy, pvestatd, pve-firewall,
corosync и watchdog-mux, и только те, которые сам узел объявляет
включёнными, поэтому отдельный узел без corosync или HA не считает ничего недостающим.
Интерфейс считается offline, когда он настроен на запуск при загрузке и не поднят (или вообще больше не существует). Поднимаемый по требованию, без autostart, никогда не сообщается: его отсутствие нормально. Мост, не вернувшийся после перезагрузки, отрезает всех подключённых к нему гостей, хотя каждый из них работает прекрасно, и больше ничто об этом не говорит.
Заполнившийся пул LVM thin переводит всех гостей, хранящихся на нём, в режим только чтения сразу, а удаление файлов внутри гостей не возвращает место. Его метаданные находятся на отдельном, гораздо меньшем томе и часто заполняются первыми, с точно таким же последствием — поэтому два уровня заполнения — отдельные ряды и отдельные правила.
Изменения пакетов обнаруживает сам коллектор: он запоминает установленные версии из предыдущего опроса (по монитору и узлу, в памяти — после перезапуска сервера он учится заново, ничего не сообщая). Учитывается только пакет, присутствующий в обоих опросах с разной версией; новоустановленный или удалённый пакет не учитывается.
Частичный сбой (один узел недоступен, одно хранилище медленное) всё равно считается успешным опросом:
то, что удалось прочитать, записывается, а сбой учитывается в scrape_errors.
Функции, которых просто нет, молчат: отсутствие Ceph, задания репликации, пула
ZFS, гостевого агента или права на перечень обновлений не порождает ни рядов, ни
ошибки. То же относится ко всему вышесказанному: отсутствующая привилегия (403),
эндпоинт, которого нет в более старом Proxmox (404 или 501), не
установленная функция (Ceph отвечает 500) не вызывают ни ошибки, ни метрики —
никогда нуль, притворяющийся измерением.
Температуры плат недоступны: API Proxmox VE не предоставляет датчики, только собственную температуру SMART дисков. Установите агент DumbMonit на узел, если нужно больше.
Применяемые встроенные правила: Monitor unreachable, High CPU, Disk almost full, Filesystem almost full (forecast), Backup too old, Unusual CPU, VM or container stopped, VM or container CPU high, VM or container memory high, VM or container disk almost full, HA resource in error, Cluster lost quorum, Node offline, Storage almost full, Backup job failed, Old snapshot, Replication failed, Ceph health error, Ceph health warning, Updates pending, Security updates pending, Proxmox packages changed, Proxmox disk wearing out, Proxmox disk SMART failure, Proxmox ZFS pool degraded, Node certificate expiring, Thin pool almost full, Thin pool metadata almost full, Proxmox service down, Node network interface down, Ceph OSD down, Ceph OSD nearly full, Ceph pool almost full, Ceph noout flag left on, HA manager not reporting, Backup job excludes a disk, Guest locked.
Полный поток RRD
Заголовок раздела «Полный поток RRD»/cluster/metrics/export — эндпоинт, который потребляют собственные серверы метрик Proxmox
(InfluxDB, Graphite): всё, что измеряет pvestatd, для всего
кластера, за один вызов. Он ценен по двум причинам.
- Он несёт измерения, которых не даёт больше ничто — в частности pressure stall information (PSI) по узлам: сколько времени задачи ждут CPU, диск или память. Именно это число объясняет «всё тормозит», когда и CPU, и память выглядят нормально.
- Он читается с
history=1от последней уже виденной точки, поэтому каждая точка между двумя опросами принимается со своей меткой времени. Монитор, опрашиваемый каждые пять минут, получает свои пять одноминутных точек вместо единственного текущего значения.
Он выключен по умолчанию, и это сознательный компромисс. Эти ряды частично
повторяют те, что остальной сбор уже производит под лучшими именами, поэтому
включение metrics_export добавляет большое число рядов для хранения и просеивания
ради деталей, которые большинство установок никогда не смотрят. Имена публикуются
ровно так, как их отправляет Proxmox (node_rrd_pressure_cpu_some_avg10,
guest_rrd_netin…), а не переводятся: Proxmox добавляет новые в каждом
релизе, и написанная здесь таблица перевода устарела бы к следующему.
Нужен Sys.Audit на / — который роль DumbMonit уже имеет, если
она была выдана на /, как показано ниже.
Что подготовить в Proxmox
Заголовок раздела «Что подготовить в Proxmox»Шаги ниже — те, что показывает уведомление рядом с формой. Принцип: пользователь, зарезервированный для мониторинга, роль, которая может только читать, токен — никогда учётная запись, под которой вы входите.
-
Откройте оболочку на любом узле (в веб-интерфейсе: выберите узел, затем Shell; или SSH) и создайте пользователя, зарезервированного для мониторинга. Пароль ему не нужен: входит токен.
pveum user add dumbmonit@pve --comment "DumbMonit monitoring" -
Создайте роль только с теми привилегиями, которые использует коллектор: Sys.Audit (узлы, кластер, HA, диски и SMART, ZFS, сертификаты, версии пакетов, подписка), Datastore.Audit (хранилища и архивы резервных копий), VM.Audit (ВМ, контейнеры, снапшоты) и VM.GuestAgent.Audit (то, что гостевой агент QEMU читает внутри ВМ: использование диска, операционная система, IP-адреса). Ни одна из них ничего не может изменить.
pveum role add DumbMonit --privs "Datastore.Audit Sys.Audit VM.Audit VM.GuestAgent.Audit" -
Выдайте пользователю эту роль на весь кластер.
pveum aclmod / -user dumbmonit@pve -role DumbMonit -
Создайте API-токен пользователя. Разделение привилегий выключено, поэтому токен просто наследует права пользователя.
pveum user token add dumbmonit@pve monitor --privsep 0 -
Команда выводит таблицу с full-tokenid и value. Скопируйте full-tokenid в поле Token ID DumbMonit, а value (UUID) — в поле Secret. Секрет показывается один раз: если он утерян, удалите токен и создайте новый.
dumbmonit@pve!monitor -
Необязательно, чтобы считать ожидающие обновления и ожидающие исправления безопасности: Proxmox защищает этот список правом Sys.Modify. Выдайте его только на /nodes; без него коллектор молча пропускает список.
pveum role add DumbMonitUpdates --privs Sys.Modifypveum aclmod /nodes -user dumbmonit@pve -role DumbMonitUpdates -
В более старом Proxmox VM.GuestAgent.Audit может ещё не существовать, и команда выше отклоняется с ошибкой invalid privilege: вызовы гостевого агента тогда покрываются VM.Monitor, который, в свою очередь, был удалён в Proxmox VE 9. Используйте ту, которую знает ваша версия.
pveum role add DumbMonit --privs "Datastore.Audit Sys.Audit VM.Audit VM.Monitor" -
Предпочитаете веб-интерфейс? Те же шаги находятся в Datacenter → Permissions: Users, Roles, Add → User Permission, затем API Tokens со снятой отметкой «Privilege Separation».
-
В DumbMonit введите адрес любого узла (по умолчанию порт 8006).
Документация производителя: Proxmox VE user management.
Учётные данные
Заголовок раздела «Учётные данные»| Учётные данные | Поля |
|---|---|
| API-токен (рекомендуется) | Token ID: пользователь, realm и имя токена в том виде, как их показывает Proxmox, dumbmonit@pve!monitor. Secret: UUID, показанный один раз при создании токена. Без срока действия, на гипервизоре не открывается сессия. |
| Имя пользователя / пароль | user@realm и пароль. Тикет получается, кэшируется и обновляется за десять минут до истечения его двухчасового срока. |
API принимает токен из двух частей (token_id + secret) или, как в более старых
версиях, одной строкой token = user@realm!name=secret; оба варианта
хранятся одинаково. Целый токен, вставленный в Token ID, разделяется формой.
Роль DumbMonit выше несёт то, что PVEAuditor выдаёт для путей, которые читает
коллектор, плюс привилегию гостевого агента: коллектор выполняет только GET. По
эндпоинтам: Sys.Audit для /version, /cluster/*, /nodes/{node}/status,
services, version, network, netstat, tasks, replication,
certificates/info, disks/list, disks/smart, disks/zfs, apt/versions,
apt/repositories и subscription; Datastore.Audit для storage и
storage/{id}/content; VM.Audit для qemu, lxc, snapshot,
status/current и interfaces контейнера; VM.GuestAgent.Audit — или
VM.Monitor до Proxmox VE 9 — для agent/get-fsinfo.
Два пути требуют немного больше остальных, и оба покрываются ролью
в том виде, как она выдана на шаге 3 — на /, а не на /nodes:
Sys.Auditна/для инвентаря LVM (disks/lvm,disks/lvmthin,disks/directory) и для/cluster/metrics/export, необязательного потока RRD. Если выдано только на/nodes, ряды thin-пулов и ряды*_rrd_*молча отсутствуют.VM.GuestAgent.Auditдля двух вызовов гостевого агента, читающих операционную систему и адреса ВМ (agent/get-osinfo,agent/network-get-interfaces). В Proxmox VE 7 этой привилегии не было, и использовалсяVM.Monitor; Proxmox VE 9 отказался отVM.Monitor. Без той, которую знает ваша версия,guest_os_infoиguest_ip_infoдля ВМ просто не публикуются; контейнеры, которым агент не нужен, сохраняют свои адреса.
Единственное, чего роль не покрывает вовсе, — список ожидающих обновлений
(apt/update), который Proxmox защищает правом Sys.Modify на /nodes — необязательно,
как объясняет шаг 6; без него коллектор молча пропускает node_updates_pending и
node_updates_security_pending.
(Используйте -token 'dumbmonit@pve!monitor' вместо -user в командах aclmod
для токена, созданного с отмеченным «Privilege Separation».)
Адрес: 10.0.0.10, pve.lan, pve.lan:8006, [fd00::1] или полный URL
https://pve.example.net. Схема https и порт 8006 добавляются, если
отсутствуют.
| Ключ | Название | По умолчанию | Справка |
|---|---|---|---|
port | API port | 8006 | Используется, если адрес не задаёт порт. |
insecure_tls | Accept an unverifiable certificate | false | Proxmox по умолчанию поставляется с самоподписанным сертификатом: включите, если соединение отклоняется по этой причине. |
request_timeout_seconds | Timeout per request (seconds) | 10 | Время, отведённое на каждый вызов API, от 1 до 120. |
backup_lookback_days | Backup lookback (days) | 31 | Более старые задачи резервного копирования не рассматриваются, от 1 до 3650. |
scan_backup_storage | Inventory backup archives | true | Сканирует хранилища резервных копий, чтобы датировать последнюю копию каждой машины. Отключите, если хранилище медленно отвечает. |
nodes | Monitored nodes | (пусто) | Имена отслеживаемых узлов через запятую. Пусто: каждый узел кластера. |
cluster_resources | Read the cluster inventory | true | Один вызов /cluster/resources перечисляет все узлы, гостей, хранилища и пулы. Оставьте включённым: это единственный источник, по-прежнему видящий гостей узла, переставшего отвечать, и он экономит два вызова на узел. При выключении коллектор вместо этого обходит /nodes/{node}/qemu и /nodes/{node}/lxc и теряет пулы и блокировки. |
services | Watch node services | true | /nodes/{node}/services и version: состояние демонов Proxmox каждого узла и установленная на нём версия. Остановленный pvestatd оставляет весь кластер с замороженными числами. |
network | Watch node networking | true | /nodes/{node}/network и netstat: мосты, бонды и VLAN с состоянием линка, а также счётчики трафика сетевой карты каждого гостя. |
lvm | Watch LVM and thin pools | true | disks/lvm, disks/lvmthin и disks/directory: группы томов, thin-пулы (заполнение данных и метаданных) и каталоги-монтирования, управляемые PVE. Нужен Sys.Audit на /; иначе молчит. |
ha | High availability | true | Читает /cluster/ha/status/current и manager_status: кворум, мастер CRM, собственное представление менеджера о каждом узле, каждый LRM с возрастом последнего отчёта и каждый ресурс HA. |
backup_jobs | Scheduled backup jobs | true | Читает задания из Datacenter → Backup и гостей, не охваченных ни одним заданием. |
scan_snapshots | Inventory snapshots | true | Один вызов на гостя (четыре одновременно на узел). Отключите на очень больших кластерах. |
max_snapshot_guests | Snapshot inventory limit | 200 | Гости сверх этого числа пропускаются при каждом опросе и учитываются в guest_snapshot_guests_skipped, от 1 до 10000. |
replication | Replication jobs | true | Состояние репликации хранилищ по узлам. Молчит, если на узле нет заданий. |
ceph | Ceph health | true | Читает /cluster/ceph/status. Молчит, если Ceph не установлен. |
ceph_detail | Watch Ceph in detail | true | Состояние, использование и задержки по каждому OSD, использование по пулам, CephFS, флаги OSD и заглушённые проверки здоровья. Три вызова на одном узле плюс два на весь кластер, независимо от размера кластера. Требует включённого ceph; без Ceph молчит. |
backup_volumes | Check what backup jobs include | true | Для каждого запланированного задания: каких гостей оно охватывает и какие из их дисков реально записывает. Ловит задание, которое каждую ночь завершается успешно, пропуская диск с данными. Один вызов на задание. |
guest_os | Read guest OS and addresses | true | Операционная система и IP-адреса, видимые изнутри каждого запущенного гостя (гостевой агент QEMU для ВМ, пространство имён контейнера для контейнеров). Обновляется раз в час на гостя, а не при каждом опросе. Нужен VM.GuestAgent.Audit в Proxmox VE 8. |
metrics_export | Ingest the full RRD metric stream | false | Читает /cluster/metrics/export, поток, который потребляют собственные серверы метрик Proxmox, включая pressure stall (PSI) по узлам, и каждую точку с момента последнего опроса, а не только текущую. По умолчанию выключено: добавляемые им ряды *_rrd_* частично повторяют уже собираемые. Нужен Sys.Audit на /. |
updates | Pending updates | true | Считает пакеты, перечисленные apt/update. Нужен Sys.Modify на /nodes (см. выше); иначе молчит. |
certificates | Certificate expiry | true | Дней до истечения каждого сертификата узла (pve-ssl.pem, pveproxy-ssl.pem, pve-root-ca.pem). |
guest_agent | Ask the QEMU guest agent | true | Для каждой запущенной ВМ: status/current (баллон, флаг агента) и, когда агент включён, agent/get-fsinfo (нужен VM.GuestAgent.Audit). Четыре вызова одновременно на узел. Молчит, если агента нет. |
disks | Watch physical disks | true | disks/list плюс один вызов disks/smart на диск: состояние, износ, температура. |
zfs | Watch ZFS pools | true | disks/zfs: состояние, ёмкость, фрагментация. Без ZFS молчит. |
packages | Detect package changes | true | apt/versions в сравнении с предыдущим опросом; изменение сообщается в течение часа в node_packages_changed. |
subscription | Watch subscription and repositories | true | subscription и apt/repositories: статус, предупреждения, включённые стандартные репозитории. |
Типичные ошибки
Заголовок раздела «Типичные ошибки»| Симптом | Вероятная причина |
|---|---|
| На мониторе показана ошибка сертификата | Самоподписанный сертификат. Установите доверенный сертификат (ACME встроен в Proxmox) или включите insecure_tls. Опция никогда не включается неявно. |
| Ошибка аутентификации | Секрет вставлен в Token ID (или наоборот), отметка «Privilege Separation» осталась включённой (тогда у токена нет прав), либо роль DumbMonit не применена на /. |
| Отсутствует возраст резервной копии для гостя | В окне просмотра нет задачи vzdump и в хранилищах не найден архив; либо scan_backup_storage отключён. |
| Медленные опросы | Хранилище резервных копий, которое долго перечисляется, или много гостей для инвентаризации снапшотов. Отключите scan_backup_storage или scan_snapshots, уменьшите max_snapshot_guests или увеличьте request_timeout_seconds. |
Отсутствует node_updates_pending | У пользователя или токена нет Sys.Modify на /nodes. Выдайте роль DumbMonitUpdates из шага 6 или проигнорируйте: node_pve_packages_upgradable и node_reboot_required покрывают пакеты Proxmox и без него. |
| Нет процента памяти для ВМ | Proxmox VE 9 сообщает в инвентаре кластера память, которую ВМ занимает на хосте — с накладными расходами, поэтому регулярно выше выделенной. Процент, вычисленный по ней, навсегда оставался бы выше 100%. Честное число берётся из драйвера баллона внутри гостя; поэтому ВМ с отключённым баллонированием показывает байты, но не процент. guest_memory_host_bytes — значение со стороны хоста. |
| Нет ёмкости для хранилища резервных копий | Datastore Proxmox Backup Server, смонтированный в PVE, не сообщает размер: PVE его не читает. Он есть на странице самого монитора datastore. |
| Использование диска пусто («size only») для ВМ | У ВМ нет гостевого агента QEMU (не включён в её опциях или qemu-guest-agent не установлен внутри), либо у токена нет VM.GuestAgent.Audit. guest_agent_enabled и guest_agent_running показывают, что именно. Контейнерам он не нужен. |
Нет рядов node_disk_* | У токена нет Sys.Audit на / (роль DumbMonit его выдаёт), либо узел работает за RAID-контроллером, скрывающим SMART: disks/list тогда сообщает UNKNOWN, и node_disk_smart_failed не публикуется. |
node_packages_changed срабатывает после перезапуска сервера | Не срабатывает: первый опрос после перезапуска только узнаёт версии. Изменение сообщается лишь между двумя последовательными опросами одного процесса сервера. |
Отсутствует backup_job_last_ok{job=…}, хотя backup_job_last_ok{node=…} существует | Задачи vzdump не несут id задания (Proxmox VE старше 7.2 или задания, запущенные вручную). Состояние запусков по узлам по-прежнему есть. |
| Нет метрик Ceph или репликации | Сообщать нечего: Ceph не установлен или не настроено ни одного задания репликации. Это не ошибка. |
| Нет thin-пула или группы томов на карточке узла | Опция lvm выключена, на узле нет LVM, либо у пользователя Sys.Audit только на /nodes — этот инвентарь требует его на /. |
| Раздел Ceph отсутствует, хотя в кластере есть Ceph | ceph или ceph_detail выключены, либо каждый узел ответил на вызовы детализации ошибкой. available: false в /api/targets/{id}/proxmox/ceph означает «здесь нет Ceph», а не «ещё не собрано». |
| Нет операционной системы или IP-адреса для ВМ | Гостевой агент QEMU не включён или не установлен в этой ВМ, либо у токена нет VM.GuestAgent.Audit в Proxmox VE 8 (шаг 7). Контейнерам агент не нужен. Только что запущенный гость ждёт до часа: сведения обновляются ежечасно, а не при каждом опросе. |
| У гостя остаётся значок блокировки | Её оставили прерванные резервное копирование, миграция или снапшот. qm unlock <vmid> для ВМ, pct unlock <vmid> для контейнера — после проверки, что задание действительно завершено. |
pve_backup_excludes_disk срабатывает на машине с CD-ROM | Не срабатывает: приводы, образы cloudinit и записи, не являющиеся томами, исключаются по замыслу и никогда не сообщаются по гостям. Сработал реальный диск с backup=0. |
Нет рядов *_rrd_* | metrics_export выключен (по умолчанию так и есть), либо у пользователя нет Sys.Audit на /. |