
Proxmox VE
Hypervisor: Knoten mit ihren Daemons und ihrem Netzwerk, virtuelle Maschinen, Container, Storages, LVM-Thin-Pools, Backups, Hochverfügbarkeit, Snapshots, Replikation, Ceph bis hinunter zum OSD, physische Platten und ZFS-Pools, ausstehende Updates, Paketänderungen, Subscription und Zertifikate. Ein Monitor kann einen ganzen Cluster abdecken.
Das Knoten-Panel
Abschnitt betitelt „Das Knoten-Panel“Die Monitorseite öffnet mit einer Karte pro Knoten: CPU, Speicher und Root-Dateisystem als drei
Anzeigen, die Laufzeit und die auf diesem Knoten installierte Version von pve-manager, dann nur
das, was nicht stimmt — die nicht laufenden Daemons, die beim Booten deklarierten, aber nicht
aktiven Schnittstellen — und der Füllstand jedes LVM-Thin-Pools und jeder Volume Group. Ein
Knoten, der nicht mehr antwortet, behält seine Karte und zeigt offline.
Zwei Zeilen unter den Anzeigen, wenn der Knoten sie meldet: der Anteil der CPU-Zeit, die auf Storage gewartet wird (I/O-Wait — ein Knoten mit 10 % CPU und 30 % I/O-Wait hat keinen Spielraum mehr, und keine andere Zahl sagt das) und der Speicher, den KSM durch das Teilen identischer Seiten zwischen Gästen zurückgewonnen hat, womit ein Knoten mehr hostet, als sein RAM hergibt.
Zwei weitere Einträge kommen zur Liste „was nicht stimmt“ hinzu, beide in Worten:
- Neustart erforderlich — Ein neuerer Kernel ist installiert als der laufende. Die Karte
nennt beide Versionen, da der Knoten bis zum Neustart den alten weiterverwendet. Das stammt aus
/nodes/{node}/apt/versions, das nurSys.Auditbraucht; - Updates ausstehend — wie viele Proxmox-Pakete eine neuere Kandidatenversion haben, aus
demselben Aufruf. Das ist nicht dasselbe wie
apt/update, das jedes ausstehende Paket des Systems zählt, aberSys.Modifybraucht und meist abgelehnt wird.
Meldet der Cluster einen HA-Watchdog (Proxmox VE 9 und neuer), wird sein Zustand neben dem Panel-Titel angegeben: HA-Fencing scharf, sobald Ressourcen an HA übergeben sind, HA-Fencing im Standby, solange keine übergeben sind — dann wird kein Knoten gefenct, was normal ist, aber gut zu wissen, bevor man sich darauf verlässt.
Ein Cluster, der Knoten für Knoten aktualisiert wurde, zeigt das hier: /version antwortet für
den Knoten, der gefragt wurde, daher trägt jede Karte ihre eigene Version, und ein Nachzügler
ist sichtbar, ohne eine Shell zu öffnen.
Die Daten stammen aus GET /api/targets/{id}/proxmox/nodes, gelesen aus der letzten Prüfung im
Metrikspeicher.
Das Gäste-Panel
Abschnitt betitelt „Das Gäste-Panel“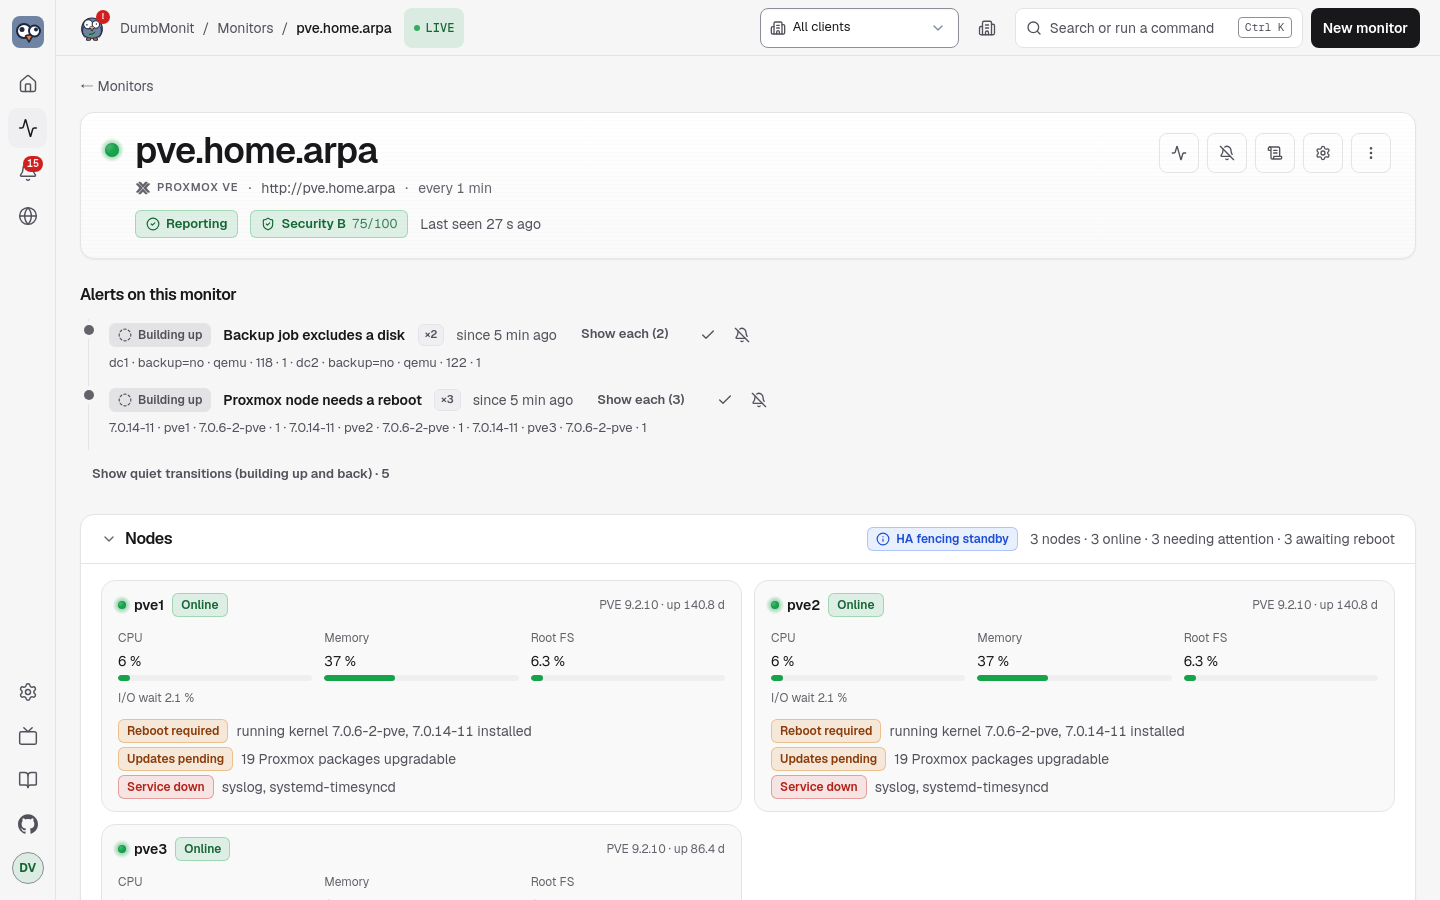
Unterhalb der Knoten das Panel Gäste: eine Zeile pro virtueller Maschine und Container, nach Knoten gruppiert, das die Fragen beantwortet, die ein Administrator zuerst stellt — läuft sie, ist sie ausgelastet, ist ihre Platte voll, wann wurde sie zuletzt gesichert. Jede Zeile zeigt:
| Spalte | Quelle | Hinweise |
|---|---|---|
| Status | Wort + Plakette: running, stopped, paused, suspended, template | Eine Vorlage wird aufgeführt, zählt aber nie als „gestoppt“. |
| Name, VMID, Knoten | das Inventar | |
| CPU | guest_cpu_percent, der dem Gast zugewiesenen Kerne | Ein Balken plus die Anzahl der Kerne. |
| Speicher | guest_memory_used_bytes / guest_memory_total_bytes | Die Balloon-Größe, wenn die VM einen hat. Eine zweite Zeile, +N auf dem Host, erscheint, wenn guest_memory_host_bytes spürbar über dem liegt, was der Gast sieht: Ein QEMU-Prozess kostet den Hypervisor mehr als den Speicher, den er herausgibt, und dieser Überschuss ist der Emulations-Overhead. Unter 64 MiB oder 5 % bleibt die Zeile weg. |
| Platte | guest_disk_used_bytes / guest_disk_total_bytes | Container: echte Nutzung. VMs: immer die Größe; die Nutzung nur, wenn der QEMU-Gast-Agent antwortet (siehe unten), sonst „nur Größe“. |
| Netzwerk | rate(guest_network_in/out_bytes) über die letzten Prüfungen | |
| Laufzeit | guest_uptime_seconds | |
| Letztes Backup | backup_last_age_seconds | Leer, wenn kein Backup bekannt ist. |
| HA | ha_resource_state_info | Nur für Gäste unter Hochverfügbarkeit. |
| Sperre | guest_locked | Ein Badge, nur solange eine Sperre gehalten wird (backup, migrate, snapshot …). |
Die Liste sortiert nach jeder Spalte, filtert nach Knoten, Status oder Pool, und jede
Knotengruppe lässt sich einklappen. Ein Klick auf eine Zeile öffnet ihre CPU und ihren Speicher
über den Zeitbereich der Seite, zusammen mit dem Betriebssystem und den IP-Adressen, die von
innen im Gast gesehen werden. Die Daten stammen aus GET /api/targets/{id}/proxmox/guests, das
die letzte Prüfung aus dem Metrikspeicher liest — vom Hypervisor wird nichts abgefragt.
Eine Sperre ist für die wenigen Minuten, die ein Backup, eine Migration oder ein Snapshot dauert,
normal. Von einem unterbrochenen Job zurückgelassen, blockiert sie jede Operation auf diesem Gast
— auch das Backup der nächsten Nacht —, bis qm unlock (oder pct unlock) sie löst; deshalb
löst „Gast gesperrt“ nach sechs Stunden aus.
Das Inventar stammt aus /cluster/resources, dem eigenen Cache des Clusters, sodass die Gäste
eines nicht mehr antwortenden Knotens weiter aufgeführt werden — mit dem Status unknown und
ihren Größen, ohne Live-Messungen — statt in dem Moment aus dem Panel zu verschwinden, in dem man
sie ansehen will. Es kostet außerdem pro Knoten zwei API-Aufrufe weniger als das Durchlaufen von
/nodes/{node}/qemu und /nodes/{node}/lxc, worauf die Option cluster_resources ausweicht,
wenn sie ausgeschaltet ist.
Plattennutzung innerhalb einer VM: der QEMU-Gast-Agent
Abschnitt betitelt „Plattennutzung innerhalb einer VM: der QEMU-Gast-Agent“Proxmox sieht die Platte einer VM als undurchsichtiges Volume: disk ist bei einer VM immer 0,
nur ihre Größe ist bekannt. Um die Nutzung von innen zu lesen, fragt der Collector den
QEMU-Gast-Agent (agent/get-fsinfo) für jede laufende VM, deren Konfiguration den Agenten
aktiviert (Optionen → QEMU Guest Agent). Zwei Bedingungen:
qemu-guest-agentist in der VM installiert und läuft (Debian und Ubuntu:apt install qemu-guest-agent; Windows: die VirtIO-Treiber-ISO);- das Token hat
VM.GuestAgent.Auditauf der VM —VM.Monitorvor Proxmox VE 9 (die unten stehende RolleDumbMonitgewährt es auf/).
Das Root-Dateisystem (/, oder C:\ unter Windows; andernfalls das größte) liefert
guest_disk_used_bytes und guest_disk_used_percent, dieselben Serien wie bei einem Container,
sodass die Regel „VM- oder Container-Platte fast voll“ beide abdeckt. Jedes echte Dateisystem
erhält außerdem guest_fs_total/used_bytes und guest_fs_used_percent mit einem Label
mountpoint; Pseudo-Dateisysteme (tmpfs, squashfs, Snap-Mounts) und Medien ohne Kapazität werden
übersprungen. guest_agent_enabled sagt, ob die Konfiguration der VM den Agenten aktiviert,
guest_agent_running, ob er geantwortet hat. Ohne den Agenten oder das Recht behält die VM ihre
Größe und hat schlicht keine Nutzung — nie ein irreführendes „0 %“.
Das Betriebssystem und die Adressen eines Gasts
Abschnitt betitelt „Das Betriebssystem und die Adressen eines Gasts“Proxmox kennt nur den in der Konfiguration eines Gasts geschriebenen OS-Typ (l26, win11),
nicht, was tatsächlich läuft. Bei eingeschalteter Option guest_os fragt der Collector jeden
laufenden Gast, was er ist: agent/get-osinfo und agent/network-get-interfaces für eine VM,
/nodes/{node}/lxc/{vmid}/interfaces für einen Container, was innen nichts Installiertes
braucht. Das liefert guest_os_info (Debian GNU/Linux 12 (bookworm), seine ID, seine Version,
den Kernel) und bis zu vier guest_ip_info — Loopback- und IPv6-Link-Local-Adressen werden
übersprungen, und eine Maschine mit Dutzenden virtueller Schnittstellen füllt die
Serien-Datenbank nicht.
Beides wird höchstens einmal pro Stunde und Gast abgefragt und zwischendurch aus dem Speicher neu veröffentlicht: Ein Betriebssystem ändert sich zwischen zwei Prüfungen nicht, und eine Adresse fast nie. Bei einem Cluster mit fünfzig laufenden Maschinen ist das der Unterschied zwischen zwei zusätzlichen Aufrufen pro Prüfung und zwei pro Stunde.
Diese beiden Agent-Aufrufe brauchen VM.GuestAgent.Audit. Proxmox VE 7 hatte es nicht und
verwendete VM.Monitor; Proxmox VE 9 hat VM.Monitor entfernt und behält nur die
Gast-Agent-Privilegien. Ohne das, das Ihre Version kennt, fehlen die beiden Serien einfach;
sonst ändert sich nichts.
Das Ceph-Panel
Abschnitt betitelt „Das Ceph-Panel“Ein Abschnitt Ceph erscheint auf der Monitorseite nur, wenn der Cluster tatsächlich Ceph hat: Zustand und die Worte dahinter, Gesamt- und genutzte Kapazität, wie viele OSDs up und in sind, eine Tabelle der OSDs (Host, Geräteklasse, Nutzung, Apply- und Commit-Latenz) und eine Tabelle der Pools (Nutzung, Size und Min Size, Placement Groups gegenüber der Zahl, die der Autoscaler wählen würde), die CephFS-Dateisysteme, die gesetzt gebliebenen OSD-Flags und die derzeit stummgeschalteten Health-Checks.
Diese letzten beiden sind die, die ein Dashboard gewöhnlich versteckt. Ein für eine Wartung
gesetztes und nie gelöschtes noout bedeutet, dass Ceph einen toten OSD nie wieder
herausbalanciert, und ein stummgeschalteter Check erscheint nicht mehr in HEALTH_OK — in beiden
Fällen sieht der Cluster gesund aus, während seine Redundanz still verschwindet.
GET /api/targets/{id}/proxmox/ceph antwortet mit available: false, wenn der Cluster kein Ceph
hat, woran die Oberfläche erkennt, den Abschnitt gar nicht zu zeichnen. Das Detail kostet drei
Aufrufe auf einem einzelnen Knoten plus zwei clusterweit, unabhängig von der Größe des Clusters,
und braucht die Option ceph_detail zusätzlich zu ceph.
Was überwacht wird
Abschnitt betitelt „Was überwacht wird“Alle Metriken haben das Präfix dumbmonit_proxmox_.
| Familie | Metriken | Labels |
|---|---|---|
| Cluster | cluster_quorate, cluster_nodes, cluster_nodes_online, cluster_member_online; version_info (+ version, release, repoid) | cluster, node |
| Cluster-Inventar | cluster_guests_total, cluster_guests_running, cluster_templates_total (Vorlagen getrennt gezählt, nie als „gestoppt“); pool_guests, eine pro Ressourcenpool | pool |
| Knoten | node_up, node_cpu_percent, node_cpu_count, node_load1/5/15, node_memory_used/total_bytes, node_memory_percent, node_swap_used/total_bytes, node_rootfs_used/total/avail_bytes, node_rootfs_percent, node_cpu_iowait_percent (Zeit des Wartens auf Platten — ein Knoten mit 10 % CPU und 30 % iowait hat keinen Spielraum), node_ksm_shared_bytes (durch Seitendeduplizierung zurückgewonnener Speicher), node_uptime_seconds, node_version_info | node |
| Knoten-Dienste | node_service_running, node_service_state_info (+ state), node_services_failed, node_core_services_down; node_pve_version_info (+ version, release) für den Knoten, der geantwortet hat | node, service |
| Knoten-Netzwerk | node_interface_active, node_interface_exists, node_interface_autostart, node_interface_mtu, node_interface_offline; Summe node_interfaces_offline | node, iface, type (bridge, bond, vlan, eth …) |
| LVM, Thin-Pools und Mounts | node_lvm_vg_size/free_bytes, node_lvm_vg_used_percent, node_lvm_vg_physical_volumes (Label vg); node_thinpool_size_bytes, node_thinpool_used_bytes, node_thinpool_used_percent, node_thinpool_metadata_size_bytes, node_thinpool_metadata_used_percent (Labels vg, pool); node_directory_mount_info (+ path, device, fstype), node_directory_mounts | node, vg, pool |
| Gäste (VMs und Container) | guest_status_info (+ status: running, stopped, paused, suspended, template), guest_running (nicht für Vorlagen), guest_cpu_percent (der zugewiesenen Kerne), guest_cpu_count, guest_memory_used/total_bytes, guest_memory_host_bytes (Proxmox VE 9: der Speicher, den die VM auf dem Host belegt, Emulations-Overhead eingeschlossen), guest_memory_percent (aus Sicht des Gasts selbst; unter Proxmox VE 9 stammt er vom Balloon-Treiber, und eine VM ohne einen hat Bytes, aber keinen Prozentwert, statt einer Zahl über 100 %), guest_disk_total_bytes, guest_disk_used_bytes und guest_disk_used_percent (Container; VMs nur über den Gast-Agenten), guest_disk_read/write_bytes, guest_network_in/out_bytes (Zähler), guest_uptime_seconds; guest_pool_info (+ pool), guest_locked (+ lock; die Serie existiert nur, solange die Sperre gehalten wird, sodass ihre Dauer direkt am Diagramm abzulesen ist) | node, vmid, name, type (qemu oder lxc) |
| VM-Details (laufende VMs) | guest_agent_enabled, guest_agent_running, guest_balloon_bytes, guest_memory_guest_free_bytes (freier Speicher von innen gesehen, Balloon-Treiber), guest_running_qemu_info (+ version: das QEMU, mit dem die VM gestartet wurde — nach einem Hypervisor-Upgrade bleibt es zurück, bis die VM gestoppt und neu gestartet wird, was eine Live-Migration nicht tut); pro Dateisystem guest_fs_total_bytes, guest_fs_used_bytes, guest_fs_used_percent | node, vmid, name, type; Dateisysteme: + mountpoint, fstype |
| Gast-System und Adressen | guest_os_info (+ os, os_id, os_version, kernel), guest_ip_info (+ iface, ip; höchstens vier routbare Adressen pro Gast). Einmal pro Stunde aktualisiert | node, vmid, name, type |
| Gast-Netzwerkkarten | guest_netdev_in_bytes, guest_netdev_out_bytes (Zähler), ein Paar pro virtueller Schnittstelle, wo guest_network_in/out_bytes nur die Summe des Gasts liefert | node, vmid, dev (tap100i0, veth200i0) |
| Storages | storage_active, storage_enabled, storage_used/total/avail_bytes, storage_used_percent (Kapazität wird nur veröffentlicht, wenn Proxmox eine meldet: Ein inaktives Storage oder ein PBS-Datastore, dessen Größe PVE nicht liest, erhält keine statt null Bytes) | node, storage, type (dir, lvmthin, zfspool, nfs, pbs …), shared |
| Backups (pro Gast) | backup_present, backup_last_timestamp_seconds, backup_last_age_seconds, backup_last_size_bytes, backup_count; Summen backup_guests_total, backup_guests_without_backup | vmid, name, node, type |
| Backups (vzdump-Läufe, pro Knoten) | backup_job_runs, backup_job_failures, backup_job_last_ok, backup_job_last_timestamp_seconds, backup_job_last_age_seconds, backup_job_last_duration_seconds | node |
| Backup-Jobs (geplant) | backup_job_enabled, backup_job_next_run_seconds, backup_job_last_ok, backup_job_last_run_age_seconds (die letzten beiden nur, wenn ein vzdump-Task die Job-ID trägt, PVE 7.2+); Summen backup_jobs_total, backup_guests_not_covered; backup_covered pro Gast (0 für einen Gast, den kein Job abdeckt) | job, storage, schedule; backup_covered: vmid, name, node, type |
| Abdeckung der Backup-Jobs | backup_job_guests, backup_job_volumes_included, backup_job_volumes_excluded; backup_job_guest_excluded_volumes (+ vmid, name, type, reason), nur bei einem unerwarteten Ausschluss veröffentlicht | job |
| HA | ha_quorum_ok, ha_fencing_armed (+ state: Proxmox VE 9 meldet, ob der Watchdog armed oder im standby ist — im Standby wird nichts gefenct), ha_master_active, ha_lrm_active (node), ha_resources_total; pro Ressource ha_resource_started, ha_resource_error (1 im Zustand error, fence oder recovery), ha_resource_state_info (+ state) | sid, node, vmid, type |
| HA-Manager | ha_node_online, ha_node_status_info (+ status: online, fence, gone, maintenance), ha_master_info (der Knoten, der den CRM-Master hält), ha_manager_age_seconds; pro Knoten ha_lrm_mode_info (+ mode, state), ha_lrm_age_seconds, ha_lrm_stale (1, wenn der LRM seit mehr als zwei Minuten nicht geschrieben hat) | node |
| Snapshots | guest_snapshot_count, guest_snapshot_oldest_age_seconds, guest_snapshot_newest_age_seconds (Alter nur bei count > 0); guest_snapshot_guests_skipped, wenn max_snapshot_guests überschritten wird | vmid, name, node, type |
| Replikation | replication_job_enabled, replication_job_error (Fehlermeldung oder fail_count > 0), replication_job_fail_count, replication_job_last_sync_age_seconds, replication_job_next_sync_seconds, replication_job_duration_seconds; replication_jobs_total | job, vmid, node (Quelle), to_node |
| Ceph | ceph_health (0 OK, 1 WARN, 2 ERR, 3 unbekannt), ceph_health_info (+ status), ceph_osds_total/up/in, ceph_bytes_total/used, ceph_used_percent, ceph_pgs_total, ceph_mons_total | |
| Ceph-OSDs | ceph_osd_up, ceph_osd_in, ceph_osd_used_percent, ceph_osd_used_bytes, ceph_osd_total_bytes, ceph_osd_apply_latency_ms, ceph_osd_commit_latency_ms, ceph_osd_reweight, ceph_osd_crush_weight; Summen ceph_osds_down, ceph_osds_out | osd, ceph_host, device_class |
| Ceph-Pools und CephFS | ceph_pool_used_percent, ceph_pool_used_bytes, ceph_pool_size, ceph_pool_min_size, ceph_pool_pg_num, ceph_pool_pg_num_optimal (was der Autoscaler wählen würde), ceph_pool_info (+ type, crush_rule, autoscale), ceph_pools_total; ceph_fs_info (+ metadata_pool, data_pool), ceph_fs_total | pool; CephFS: name |
| Ceph-Flags und Stummschaltungen | ceph_flag (1, solange das Flag gesetzt ist), ceph_flags_set; ceph_health_mute_info (+ sticky), ceph_health_mutes | flag; Stummschaltungen: code |
| Physische Platten | node_disk_size_bytes, node_disk_smart_failed (1, wenn der SMART-Zustand FAILED ist; fehlt, wenn die Platte UNKNOWN meldet), node_disk_health_info (+ health, used: LVM, ZFS, partitions …), node_disk_wearout_percent (SSD und NVMe: 0 neu, 100 Ende der Nennlebensdauer), node_disk_temperature_celsius (aus disks/smart: ATA-Attribut 194/190 oder die Temperaturzeile eines Textberichts — Temperature: bei NVMe, Current Drive Temperature: bei SAS) | node, disk (/dev/sda, /dev/nvme0n1), model, type (ssd, hdd, nvme) |
| ZFS-Pools | node_zfs_pool_degraded (1, außer ONLINE), node_zfs_pool_health_info (+ health), node_zfs_pool_size/alloc/free_bytes, node_zfs_pool_used_percent, node_zfs_pool_fragmentation_percent | node, pool |
| Updates | node_updates_pending, node_updates_security_pending (Pakete, deren Herkunft, Repository-Label, Suite, Sektion oder Changelog-URL ein Sicherheitsarchiv nennt, etwa bookworm-security von Debian). Ohne Sys.Modify existieren diese beiden nicht; node_pve_packages_upgradable zählt dann weiterhin die Proxmox-Pakete, deren Kandidatenversion von der installierten abweicht, und node_reboot_required (+ running, installed) sagt, dass ein neuerer Kernel installiert, aber noch nicht gebootet ist — beides aus apt/versions gelesen, das nur Sys.Audit braucht | node |
| Paketänderungen | node_packages_changed: normalerweise 0; für eine Stunde, nachdem eine Prüfung eine Änderung der installierten Version eines Proxmox-Pakets sieht (apt/versions), die Anzahl der geänderten Pakete, mit einem Label changes wie pve-manager 8.2.4→8.2.7, proxmox-kernel-6.8 6.8.8-2→6.8.12-2 | node, changes |
| Subscription und Repositories | node_subscription_active, node_subscription_info (+ status: active, notfound, expired …, level, next_due); node_repository_errors (nicht lesbare Sources-Dateien), node_repository_warnings (eigene Warnungen von Proxmox: Enterprise-Repository ohne Subscription, Test-Repository), node_repository_enabled (+ repo: enterprise, no-subscription, test, ceph-*) | node |
| Zertifikate | node_certificate_expiry_days (negativ nach Ablauf) | node, filename, subject |
| RRD-Stream (standardmäßig aus) | node_rrd_<metric>, guest_rrd_<metric>, storage_rrd_<metric> — jede Messung, die die eigenen Metrikserver von Proxmox erhalten, unter ihrem eigenen Namen (siehe metrics_export unten) | node; Gäste: vmid, type; Storages: node, storage |
| Erfassung | up, scrape_errors, scrape_duration_seconds |
Das Backup-Alter pro Maschine beantwortet den teuersten Fehler eines Homelabs: das Backup, das
seit Wochen nicht lief und erst am Tag der Wiederherstellung entdeckt wird. Es wird aus dem
vzdump-Tasklog berechnet (über backup_lookback_days) und, wenn scan_backup_storage an ist,
aus den auf den Backup-Storages gefundenen Archiven.
Geplante Jobs stammen aus Datacenter → Backup: backup_covered ist 0 für jeden Gast, den Proxmox
selbst als von keinem Job abgedeckt aufführt, sodass eine gestern erstellte Maschine vor ihrem
ersten verpassten Backup auftaucht statt danach.
Ein Job, der einen Gast abdeckt, schreibt nicht unbedingt alle seine Platten. Ein mit backup=0
markiertes Volume wird jede Nacht übersprungen, der Job meldet weiter Erfolg, und niemand merkt
es bis zu einer Wiederherstellung. backup_job_guest_excluded_volumes nennt den Job, den Gast
und den eigenen Grund von Proxmox für den Ausschluss — aber nur, wenn der Ausschluss eine
Überraschung ist: Ein CD-ROM-Laufwerk, ein Cloudinit-Image oder ein Eintrag, der gar kein Volume
ist, ist konstruktionsbedingt ausgeschlossen, wird in backup_job_volumes_excluded gezählt und nie
pro Gast gemeldet. Ohne diese Unterscheidung würde jede Maschine mit einem virtuellen Laufwerk
einen Alarm auslösen.
Die Daemons eines Knotens zu überwachen lohnt aus einem Grund: Ein gestoppter pvestatd zerstört
nichts sichtbar — die Weboberfläche zeigt weiter die Zahlen aus dem Moment seines Todes, und alles
sieht normal aus. node_core_services_down zählt nur pve-cluster, pvedaemon, pveproxy,
pvestatd, pve-firewall, corosync und watchdog-mux, und nur die, die der Knoten selbst als
aktiviert deklariert, sodass ein eigenständiger Knoten ohne corosync oder HA nichts als fehlend
zählt.
Eine Schnittstelle zählt als offline, wenn sie beim Booten starten soll und nicht aktiv ist (oder gar nicht mehr existiert). Eine bei Bedarf hochgefahrene, ohne Autostart, wird nie gemeldet: Ihr Fehlen ist normal. Eine Bridge, die nach einem Neustart nicht zurückkommt, schneidet jeden an ihr hängenden Gast ab, während jeder dieser Gäste einwandfrei läuft, und nichts anderes sagt es.
Ein volllaufender LVM-Thin-Pool setzt jeden darauf gespeicherten Gast auf einmal auf Read-only, und das Löschen von Dateien in den Gästen gibt den Platz nicht zurück. Seine Metadaten liegen auf einem eigenen, weit kleineren Volume und sind oft zuerst gesättigt, mit genau derselben Folge — deshalb sind die beiden Füllstände getrennte Serien und getrennte Regeln.
Paketänderungen werden vom Collector selbst erkannt: Er merkt sich die installierten Versionen der vorherigen Prüfung (pro Monitor und Knoten, im Speicher — ein Serverneustart lernt neu, ohne etwas zu melden). Nur ein in beiden Prüfungen vorhandenes Paket mit abweichender Version zählt; ein neu installiertes oder entferntes nicht.
Ein Teilausfall (ein Knoten down, ein Storage langsam) ist weiterhin eine erfolgreiche Prüfung:
Was gelesen werden konnte, wird geschrieben, und der Fehler wird in scrape_errors gezählt.
Funktionen, die schlicht fehlen, bleiben still: kein Ceph, kein Replikationsjob, kein ZFS-Pool,
kein Gast-Agent oder kein Recht, Updates aufzulisten, erzeugen weder Serien noch einen Fehler.
Dasselbe gilt für alles oben Genannte: ein fehlendes Privileg (403), ein Endpunkt, den ein älteres
Proxmox nicht hat (404 oder 501), eine nicht installierte Funktion (Ceph antwortet 500) erzeugen
weder einen Fehler noch eine Metrik — nie eine Null, die eine Messung vortäuscht.
Platinentemperaturen sind nicht verfügbar: Die Proxmox-VE-API stellt keine Sensoren bereit, nur die eigene SMART-Temperatur der Platten. Installieren Sie den DumbMonit-Agenten auf dem Knoten, wenn Sie mehr brauchen.
Zutreffende integrierte Regeln: Monitor nicht erreichbar, CPU hoch, Platte fast voll, Dateisystem fast voll (Prognose), Backup zu alt, Ungewöhnliche CPU, VM oder Container gestoppt, VM- oder Container-CPU hoch, VM- oder Container-Speicher hoch, VM- oder Container-Platte fast voll, HA-Ressource im Fehler, Cluster hat Quorum verloren, Knoten offline, Storage fast voll, Backup-Job fehlgeschlagen, Alter Snapshot, Replikation fehlgeschlagen, Ceph-Zustand Fehler, Ceph-Zustand Warnung, Updates ausstehend, Sicherheitsupdates ausstehend, Proxmox-Pakete geändert, Proxmox-Platte verschleißt, Proxmox-Platte SMART-Fehler, Proxmox-ZFS-Pool degradiert, Knotenzertifikat läuft ab, Thin-Pool fast voll, Thin-Pool-Metadaten fast voll, Proxmox-Dienst ausgefallen, Netzwerkschnittstelle des Knotens ausgefallen, Ceph-OSD ausgefallen, Ceph-OSD fast voll, Ceph-Pool fast voll, Ceph-Flag noout gesetzt belassen, HA-Manager meldet nicht, Backup-Job schließt eine Platte aus, Gast gesperrt.
Der vollständige RRD-Stream
Abschnitt betitelt „Der vollständige RRD-Stream“/cluster/metrics/export ist der Endpunkt, den die eigenen Metrikserver von Proxmox (InfluxDB,
Graphite) konsumieren: alles, was pvestatd misst, für den ganzen Cluster, in einem Aufruf. Zwei
Dinge machen ihn wertvoll.
- Er enthält Messungen, die sonst nichts bereitstellt — insbesondere die Pressure Stall Information (PSI) pro Knoten: wie lange Tasks auf CPU, Platte oder Speicher warten. Das ist die Zahl, die „alles ist langsam“ erklärt, wenn CPU und Speicher beide unauffällig aussehen.
- Er wird mit
history=1ab dem letzten bereits gesehenen Punkt gelesen, sodass jeder Punkt zwischen zwei Prüfungen mit seinem eigenen Zeitstempel aufgenommen wird. Ein alle fünf Minuten geprüfter Monitor erhält seine fünf Ein-Minuten-Punkte statt eines einzigen aktuellen Werts.
Er ist standardmäßig aus, und das ist ein bewusster Kompromiss. Diese Serien wiederholen
teilweise solche, die der Rest der Erfassung bereits unter besseren Namen erzeugt, sodass das
Einschalten von metrics_export eine große Zahl Serien hinzufügt, die gespeichert und
durchsucht werden müssen, für Details, die die meisten Installationen nie ansehen. Die Namen
werden genau so veröffentlicht, wie Proxmox sie sendet (node_rrd_pressure_cpu_some_avg10,
guest_rrd_netin …), statt übersetzt zu werden: Proxmox fügt mit jedem Release neue hinzu, und
eine hier geschriebene Übersetzungstabelle wäre beim nächsten falsch. Er braucht Sys.Audit auf
/ — was die Rolle DumbMonit bereits hat, wenn sie wie unten auf / gewährt wurde.
Was in Proxmox vorzubereiten ist
Abschnitt betitelt „Was in Proxmox vorzubereiten ist“Die folgenden Schritte sind die, die der Hinweis neben dem Formular zeigt. Das Prinzip: ein für die Überwachung reservierter Benutzer, eine Rolle, die nur lesen kann, ein Token — nie das Konto, mit dem Sie sich anmelden.
-
Öffnen Sie eine Shell auf einem beliebigen Knoten (in der Weboberfläche: den Knoten auswählen, dann Shell; oder SSH) und erstellen Sie einen für die Überwachung reservierten Benutzer. Er braucht kein Passwort: Das Token meldet sich an.
pveum user add dumbmonit@pve --comment "DumbMonit monitoring" -
Erstellen Sie eine Rolle mit nur den Privilegien, die der Collector verwendet: Sys.Audit (Knoten, Cluster, HA, Platten und SMART, ZFS, Zertifikate, Paketversionen, Subscription), Datastore.Audit (Storages und Backup-Archive), VM.Audit (VMs, Container, Snapshots) und VM.GuestAgent.Audit (was der QEMU-Gast-Agent innerhalb einer VM liest: Plattennutzung, Betriebssystem, IP-Adressen). Keines davon kann etwas ändern.
pveum role add DumbMonit --privs "Datastore.Audit Sys.Audit VM.Audit VM.GuestAgent.Audit" -
Geben Sie dem Benutzer diese Rolle auf dem gesamten Cluster.
pveum aclmod / -user dumbmonit@pve -role DumbMonit -
Erstellen Sie das API-Token des Benutzers. Die Privilegientrennung ist aus, das Token erbt also einfach die Rechte des Benutzers.
pveum user token add dumbmonit@pve monitor --privsep 0 -
Der Befehl gibt eine Tabelle mit full-tokenid und value aus. Kopieren Sie full-tokenid in das Feld Token-ID von DumbMonit und value (die UUID) in dessen Feld Secret. Das Secret wird nur einmal angezeigt: Geht es verloren, entfernen Sie das Token und erstellen Sie ein neues.
dumbmonit@pve!monitor -
Optional, um ausstehende Updates und ausstehende Sicherheitskorrekturen zu zählen: Proxmox schützt diese Liste mit Sys.Modify. Gewähren Sie es nur auf /nodes; ohne es überspringt der Collector die Liste still.
pveum role add DumbMonitUpdates --privs Sys.Modifypveum aclmod /nodes -user dumbmonit@pve -role DumbMonitUpdates -
Bei einem älteren Proxmox existiert VM.GuestAgent.Audit möglicherweise noch nicht, und der obige Befehl wird mit invalid privilege abgelehnt: Die Gast-Agent-Aufrufe werden dann von VM.Monitor abgedeckt, das Proxmox VE 9 seinerseits entfernt hat. Verwenden Sie, was Ihre Version kennt.
pveum role add DumbMonit --privs "Datastore.Audit Sys.Audit VM.Audit VM.Monitor" -
Lieber die Weboberfläche? Dieselben Schritte finden Sie unter Datacenter → Permissions: Users, Roles, Add → User Permission, dann API Tokens mit abgehaktem „Privilege Separation“.
-
Geben Sie in DumbMonit die Adresse eines beliebigen Knotens ein (standardmäßig Port 8006).
Herstellerdokumentation: Proxmox VE user management.
Zugangsdaten
Abschnitt betitelt „Zugangsdaten“| Zugangsdaten | Felder |
|---|---|
| API-Token (empfohlen) | Token-ID: Benutzer, Realm und Tokenname, wie Proxmox sie zeigt, dumbmonit@pve!monitor. Secret: die UUID, die beim Erstellen des Tokens einmalig angezeigt wurde. Kein Ablauf, keine auf dem Hypervisor geöffnete Sitzung. |
| Benutzername / Passwort | user@realm und das Passwort. Ein Ticket wird bezogen, gecacht und zehn Minuten vor seinem Ablauf nach zwei Stunden erneuert. |
Die API akzeptiert das Token in zwei Teilen (token_id + secret) oder, wie ältere Versionen,
als eine Zeichenfolge token = user@realm!name=secret; beide werden gleich gespeichert. Ein in
die Token-ID eingefügtes ganzes Token wird vom Formular aufgeteilt.
Die obige Rolle DumbMonit trägt, was PVEAuditor für die vom Collector gelesenen Pfade
gewährt, plus das Gast-Agent-Privileg: Der Collector führt nur GET aus. Pro Endpunkt:
Sys.Audit für /version, /cluster/*, /nodes/{node}/status, services, version,
network, netstat, tasks, replication, certificates/info, disks/list, disks/smart,
disks/zfs, apt/versions, apt/repositories und subscription; Datastore.Audit für
storage und storage/{id}/content; VM.Audit für qemu, lxc, snapshot, status/current
und die interfaces eines Containers; VM.GuestAgent.Audit — oder VM.Monitor vor
Proxmox VE 9 — für agent/get-fsinfo.
Zwei Pfade verlangen etwas mehr als der Rest, und beide werden von der Rolle abgedeckt, wie in
Schritt 3 gewährt — auf /, nicht auf /nodes:
Sys.Auditauf/für das LVM-Inventar (disks/lvm,disks/lvmthin,disks/directory) und für/cluster/metrics/export, den optionalen RRD-Stream. Nur auf/nodesgewährt, fehlen die Thin-Pool-Serien und die Serien*_rrd_*still.VM.GuestAgent.Auditfür die beiden Gast-Agent-Aufrufe, die Betriebssystem und Adressen einer VM lesen (agent/get-osinfo,agent/network-get-interfaces). Proxmox VE 7 hatte dieses Privileg nicht und verwendeteVM.Monitor; Proxmox VE 9 hatVM.Monitorgestrichen. Ohne das, das Ihre Version kennt, werdenguest_os_infoundguest_ip_infofür VMs schlicht nicht veröffentlicht; Container, die keinen Agenten brauchen, behalten ihre Adressen.
Das Einzige, was die Rolle überhaupt nicht abdeckt, ist die Liste ausstehender Updates
(apt/update), die Proxmox mit Sys.Modify auf /nodes schützt — optional, wie Schritt 6
erklärt; ohne sie überspringt der Collector node_updates_pending und
node_updates_security_pending still.
(Verwenden Sie -token 'dumbmonit@pve!monitor' statt -user in den aclmod-Befehlen für ein
mit abgehaktem „Privilege Separation“ erstelltes Token.)
Adresse: 10.0.0.10, pve.lan, pve.lan:8006, [fd00::1] oder eine vollständige URL
https://pve.example.net. Das Schema https und Port 8006 werden ergänzt, wenn sie fehlen.
Optionen
Abschnitt betitelt „Optionen“| Schlüssel | Label | Standard | Hilfe |
|---|---|---|---|
port | API-Port | 8006 | Wird verwendet, wenn die Adresse keinen Port angibt. |
insecure_tls | Nicht prüfbares Zertifikat akzeptieren | false | Proxmox wird standardmäßig mit einem selbstsignierten Zertifikat ausgeliefert: Aktivieren Sie dies, wenn die Verbindung deshalb abgelehnt wird. |
request_timeout_seconds | Timeout pro Anfrage (Sekunden) | 10 | Für jeden API-Aufruf erlaubte Zeit, von 1 bis 120. |
backup_lookback_days | Backup-Rückblick (Tage) | 31 | Ältere Backup-Tasks werden nicht untersucht, von 1 bis 3650. |
scan_backup_storage | Backup-Archive inventarisieren | true | Durchsucht die Backup-Storages, um das letzte Backup jeder Maschine zu datieren. Deaktivieren Sie es, wenn das Storage langsam antwortet. |
nodes | Überwachte Knoten | (leer) | Namen der zu überwachenden Knoten, durch Kommas getrennt. Leer: jeder Knoten im Cluster. |
cluster_resources | Cluster-Inventar lesen | true | Ein Aufruf von /cluster/resources listet jeden Knoten, Gast, jedes Storage und jeden Pool auf. Lassen Sie es an: Es ist die einzige Quelle, die die Gäste eines nicht mehr antwortenden Knotens noch sieht, und spart zwei Aufrufe pro Knoten. Aus durchläuft der Collector stattdessen /nodes/{node}/qemu und /nodes/{node}/lxc und verliert die Pools und Sperren. |
services | Knoten-Dienste überwachen | true | /nodes/{node}/services und version: der Zustand der Proxmox-Daemons jedes Knotens und die darauf installierte Version. Ein gestoppter pvestatd lässt den ganzen Cluster eingefrorene Zahlen zeigen. |
network | Knoten-Netzwerk überwachen | true | /nodes/{node}/network und netstat: Bridges, Bonds und VLANs mit ihrem Link-Zustand, plus die Verkehrszähler jeder Gast-Netzwerkkarte. |
lvm | LVM und Thin-Pools überwachen | true | disks/lvm, disks/lvmthin und disks/directory: Volume Groups, Thin-Pools (Füllstand von Daten und Metadaten) und von PVE verwaltete Directory-Mounts. Braucht Sys.Audit auf /; sonst still. |
ha | Hochverfügbarkeit | true | Liest /cluster/ha/status/current und manager_status: Quorum, CRM-Master, die eigene Sicht des Managers auf jeden Knoten, jeden LRM mit dem Alter seiner letzten Meldung und jede HA-Ressource. |
backup_jobs | Geplante Backup-Jobs | true | Liest die Jobs aus Datacenter → Backup und die Gäste, die kein Job abdeckt. |
scan_snapshots | Snapshots inventarisieren | true | Ein Aufruf pro Gast (vier gleichzeitig pro Knoten). Deaktivieren Sie es bei sehr großen Clustern. |
max_snapshot_guests | Limit des Snapshot-Inventars | 200 | Gäste darüber hinaus werden bei jeder Prüfung übersprungen und in guest_snapshot_guests_skipped gezählt, von 1 bis 10000. |
replication | Replikationsjobs | true | Status der Storage-Replikation pro Knoten. Still, wenn der Knoten keinen Job hat. |
ceph | Ceph-Zustand | true | Liest /cluster/ceph/status. Still, wenn Ceph nicht installiert ist. |
ceph_detail | Ceph im Detail überwachen | true | Zustand, Nutzung und Latenz pro OSD, Nutzung pro Pool, CephFS, OSD-Flags und stummgeschaltete Health-Checks. Drei Aufrufe auf einem Knoten plus zwei clusterweit, unabhängig von der Clustergröße. Braucht ceph an; still ohne Ceph. |
backup_volumes | Prüfen, was Backup-Jobs einschließen | true | Für jeden geplanten Job, welche Gäste er abdeckt und welche ihrer Platten er tatsächlich schreibt. Fängt einen Job ab, der jede Nacht erfolgreich ist, aber eine Datenplatte überspringt. Ein Aufruf pro Job. |
guest_os | Gast-OS und Adressen lesen | true | Betriebssystem und IP-Adressen, von innen in jedem laufenden Gast gesehen (QEMU-Gast-Agent für VMs, der Container-Namespace für Container). Einmal pro Stunde und Gast aktualisiert, nicht bei jeder Prüfung. Braucht VM.GuestAgent.Audit unter Proxmox VE 8. |
metrics_export | Den vollständigen RRD-Metrikstream aufnehmen | false | Liest /cluster/metrics/export, den Stream, den die eigenen Metrikserver von Proxmox konsumieren, einschließlich Pressure Stall (PSI) pro Knoten, und jeden Punkt seit der letzten Prüfung statt nur den aktuellen. Standardmäßig aus: Die hinzugefügten Serien *_rrd_* wiederholen teilweise bereits erfasste. Braucht Sys.Audit auf /. |
updates | Ausstehende Updates | true | Zählt die von apt/update aufgelisteten Pakete. Braucht Sys.Modify auf /nodes (siehe oben); sonst still. |
certificates | Zertifikatsablauf | true | Verbleibende Tage jedes Knotenzertifikats (pve-ssl.pem, pveproxy-ssl.pem, pve-root-ca.pem). |
guest_agent | QEMU-Gast-Agent fragen | true | Für jede laufende VM: status/current (Balloon, Agent-Flag) und, wenn der Agent aktiviert ist, agent/get-fsinfo (braucht VM.GuestAgent.Audit). Vier Aufrufe gleichzeitig pro Knoten. Still, wenn der Agent fehlt. |
disks | Physische Platten überwachen | true | disks/list plus ein Aufruf disks/smart pro Platte: Zustand, Wearout, Temperatur. |
zfs | ZFS-Pools überwachen | true | disks/zfs: Zustand, Kapazität, Fragmentierung. Still ohne ZFS. |
packages | Paketänderungen erkennen | true | apt/versions verglichen mit der vorherigen Prüfung; eine Änderung wird eine Stunde lang in node_packages_changed gemeldet. |
subscription | Subscription und Repositories überwachen | true | subscription und apt/repositories: Status, Warnungen, aktivierte Standard-Repositories. |
Häufige Fehler
Abschnitt betitelt „Häufige Fehler“| Symptom | Wahrscheinliche Ursache |
|---|---|
| Am Monitor angezeigter Zertifikatsfehler | Selbstsigniertes Zertifikat. Installieren Sie entweder ein vertrauenswürdiges Zertifikat (ACME ist in Proxmox eingebaut) oder aktivieren Sie insecure_tls. Die Option wird nie implizit aktiviert. |
| Authentifizierungsfehler | Secret in die Token-ID eingefügt (oder umgekehrt), „Privilege Separation“ angehakt gelassen (das Token hat dann keine Rechte) oder die Rolle DumbMonit nicht auf / angewendet. |
| Backup-Alter für einen Gast fehlt | Kein vzdump-Task im Rückblickfenster und kein Archiv auf den Storages gefunden; oder scan_backup_storage deaktiviert. |
| Langsame Prüfungen | Ein Backup-Storage, dessen Auflistung lange dauert, oder viele Gäste, deren Snapshots zu inventarisieren sind. Deaktivieren Sie scan_backup_storage oder scan_snapshots, senken Sie max_snapshot_guests oder erhöhen Sie request_timeout_seconds. |
node_updates_pending fehlt | Dem Benutzer oder Token fehlt Sys.Modify auf /nodes. Gewähren Sie die Rolle DumbMonitUpdates aus Schritt 6 oder ignorieren Sie es: node_pve_packages_upgradable und node_reboot_required decken die Proxmox-Pakete auch ohne ab. |
| Kein Speicher-Prozentwert für eine VM | Proxmox VE 9 meldet im Cluster-Inventar den Speicher, den die VM auf dem Host belegt — Overhead eingeschlossen, daher regelmäßig über ihrer Zuweisung. Ein daraus berechneter Prozentwert läge ewig über 100 %. Die ehrliche Zahl stammt vom Balloon-Treiber im Gast; eine VM mit deaktiviertem Ballooning zeigt daher Bytes und keinen Prozentwert. guest_memory_host_bytes ist die Zahl der Host-Seite. |
| Keine Kapazität für das Backup-Storage | Ein auf PVE eingehängter Proxmox-Backup-Server-Datastore meldet keine Größe: PVE liest sie nicht. Die eigene Monitorseite des Datastores hat sie. |
| Plattennutzung leer („nur Größe“) bei einer VM | Die VM hat keinen QEMU-Gast-Agenten (nicht in ihren Optionen aktiviert oder qemu-guest-agent innen nicht installiert), oder dem Token fehlt VM.GuestAgent.Audit. guest_agent_enabled und guest_agent_running sagen, was zutrifft. Container brauchen ihn nie. |
Keine Serien node_disk_* | Dem Token fehlt Sys.Audit auf / (die Rolle DumbMonit gewährt es), oder der Knoten läuft hinter einem RAID-Controller, der SMART verbirgt: disks/list meldet dann UNKNOWN, und es wird kein node_disk_smart_failed veröffentlicht. |
node_packages_changed löst nach einem Serverneustart aus | Tut es nicht: Die erste Prüfung nach einem Neustart lernt nur die Versionen. Eine Änderung wird nur zwischen zwei aufeinanderfolgenden Prüfungen desselben Serverprozesses gemeldet. |
backup_job_last_ok{job=…} fehlt, während backup_job_last_ok{node=…} existiert | Die vzdump-Tasks tragen die Job-ID nicht (Proxmox VE älter als 7.2 oder von Hand ausgeführte Jobs). Der Laufstatus pro Knoten ist weiterhin da. |
| Keine Ceph- oder Replikationsmetriken | Nichts zu melden: Ceph ist nicht installiert oder es ist kein Replikationsjob konfiguriert. Kein Fehler. |
| Kein Thin-Pool oder keine Volume Group auf einer Knotenkarte | Die Option lvm ist aus, der Knoten hat kein LVM, oder der Benutzer hat Sys.Audit nur auf /nodes — dieses Inventar verlangt es auf /. |
| Der Ceph-Abschnitt fehlt, obwohl der Cluster Ceph hat | ceph oder ceph_detail ist aus, oder jeder Knoten beantwortete die Detail-Aufrufe mit einem Fehler. available: false bei /api/targets/{id}/proxmox/ceph bedeutet „hier kein Ceph“, nicht „noch nicht erfasst“. |
| Kein Betriebssystem und keine IP-Adresse für eine VM | Der QEMU-Gast-Agent ist in dieser VM nicht aktiviert oder nicht installiert, oder dem Token fehlt VM.GuestAgent.Audit unter Proxmox VE 8 (Schritt 7). Container brauchen keinen Agenten. Ein soeben gestarteter Gast wartet bis zu eine Stunde: Die Fakten werden stündlich aktualisiert, nicht bei jeder Prüfung. |
| Ein Gast behält ein Sperr-Badge | Ein unterbrochenes Backup, eine Migration oder ein Snapshot hat sie zurückgelassen. qm unlock <vmid> für eine VM, pct unlock <vmid> für einen Container — nachdem Sie geprüft haben, dass der Job wirklich beendet ist. |
pve_backup_excludes_disk löst bei einer Maschine mit CD-ROM aus | Tut es nicht: Laufwerke, Cloudinit-Images und Einträge, die keine Volumes sind, sind konstruktionsbedingt ausgeschlossen und werden nie pro Gast gemeldet. Ausgelöst hat eine echte Platte mit backup=0. |
Keine Serien *_rrd_* | metrics_export ist aus (standardmäßig), oder dem Benutzer fehlt Sys.Audit auf /. |