
Come funziona l'alerting
Regole utili sono attive subito dopo l’installazione; nulla ha bisogno di essere messo a punto. Ciò che fa la differenza nell’uso quotidiano è quello che mantiene basso il rumore: soppressione per dipendenza, raggruppamento per host, finestre di manutenzione, e una baseline che apprende prima di parlare.
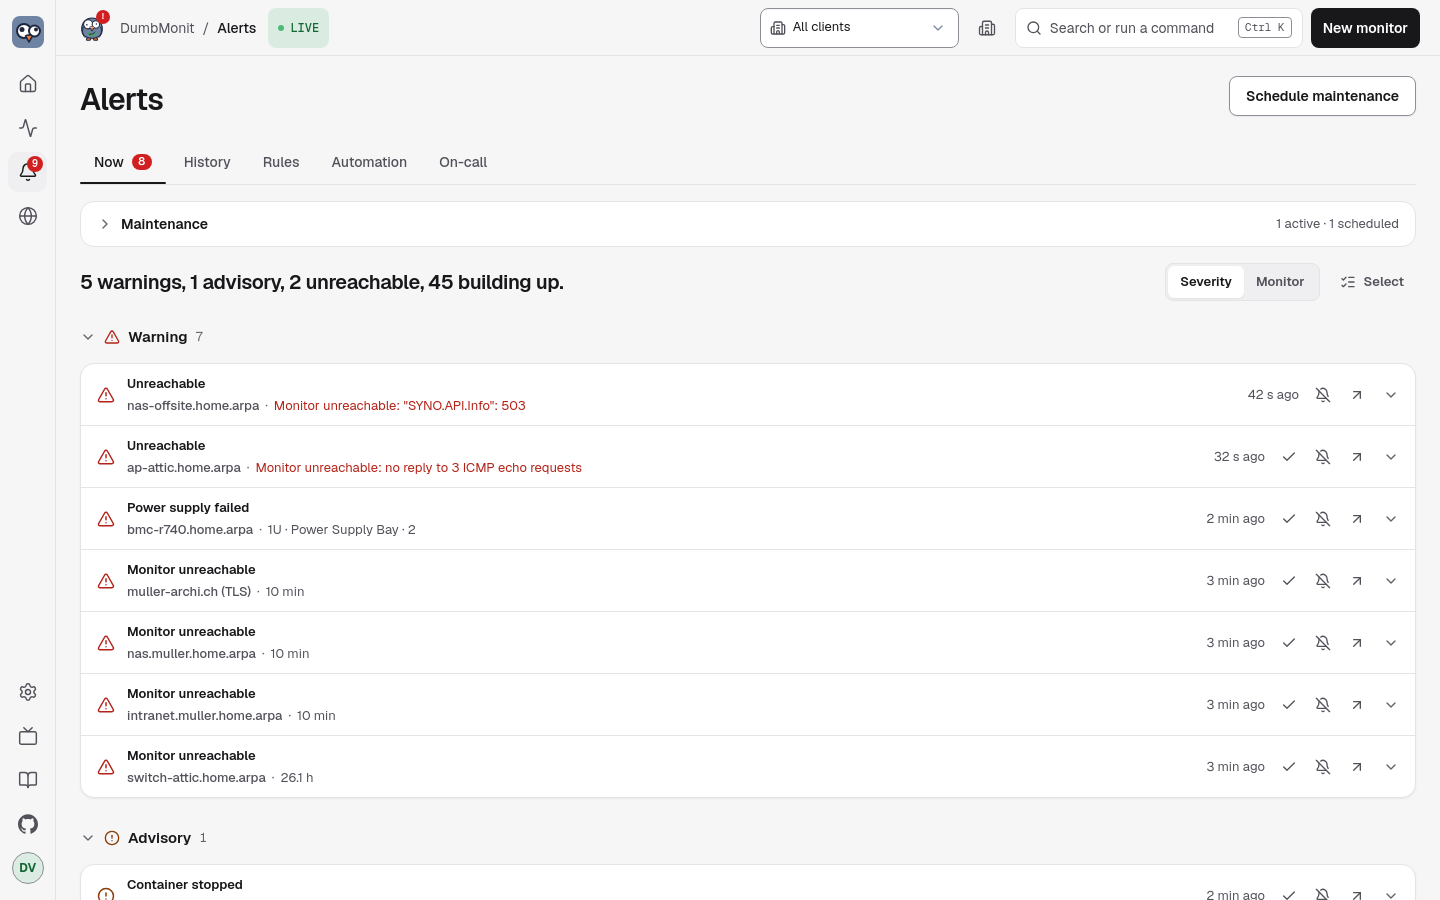
Severità
Sezione intitolata “Severità”L’interfaccia parla la scala del bollettino meteo. L’API e l’editor delle regole memorizzano gli stessi tre livelli sotto i loro nomi del motore.
| Nell’interfaccia | Nell’API (severity) | Significato |
|---|---|---|
| Info | info | Da sapere, nessuna azione prevista. Usato dalla regola di baseline. |
| Advisory | warning | Richiede attenzione a breve: CPU alta, disco quasi pieno, servizio lento. |
| Warning | critical | Richiede attenzione ora: monitor irraggiungibile, servizio inattivo, verifica di backup fallita, certificato scaduto. |
L’escalation alza la severità di una regola di un gradino dopo
escalate_after se l’avviso continua ad attivarsi (Info → Advisory →
Warning; Warning resta).
Ogni avviso è una macchina a stati, valutata ogni 30 secondi
(DUMBMONIT_ALERT_INTERVAL_SECS).
| Fase | Nell’interfaccia | Significato |
|---|---|---|
ok | — | La condizione è falsa. |
pending | Building up | La condizione è vera ma l’attesa della regola (for) non è ancora trascorsa. Nulla viene inviato. |
firing | Firing | La condizione è durata abbastanza. La prima notifica esce, poi ricordi ogni repeat_interval (6 ore per impostazione predefinita per la maggior parte delle regole integrate), poi un’escalation se configurata. |
resolved | Resolved | Tornato alla normalità. Una notifica di risoluzione viene inviata solo se l’attivazione era stata annunciata. |
suppressed | Suppressed by parent | L’avviso è attivo, ma un monitor genitore è fuori servizio, o il monitor stesso è irraggiungibile: vedi sotto. |
phase è lo stato del motore; effective_phase è ciò che leggi. Un
avviso il cui effective_phase è suppressed mantiene phase = firing
sotto, così non viene notificato di nuovo quando il genitore si
riprende.
Un avviso può anche essere confermato (acked, con acked_by,
acked_until e ack_note): la fase non si muove, i ricordi e le
escalation si fermano finché acked_until, la risoluzione viene comunque
notificata e azzera la conferma. Sospendere un avviso funziona nello
stesso modo sotto il cofano ma tramite una finestra di manutenzione
limitata alle etichette esatte di quell’avviso (silenced: true), invece
che all’intero monitor: una regola gemella sullo stesso monitor
continua a parlare. Vedi
Eliminare un avviso.
Soppressione per dipendenza
Sezione intitolata “Soppressione per dipendenza”Qualsiasi monitor può dichiarare un monitor genitore. Quando un monitor è
fuori servizio, ogni avviso sui suoi discendenti viene contrassegnato
Suppressed by parent invece di essere inviato: uno switch che si spegne
produce una notifica, non trenta. L’antenato fuori servizio più vicino viene
nominato come causa (suppressed_by), e la catena viene seguita fino a 64
livelli.
Un monitor è fuori servizio quando uno di questi avvisi si attiva su di esso, qualunque ne sia la causa:
- Monitor unreachable: nessuna misura in assoluto (un dispositivo SNMP che ha smesso di rispondere, un agent che ha smesso di inviare);
- Servizio non disponibile: il suo controllo di disponibilità viene eseguito ma fallisce (un ping con il 100 % di perdita, un controllo HTTP che dà errore o va in timeout, una porta TCP chiusa e così via).
Un semplice avvertimento sul genitore (disco pieno, CPU alta, servizio lento, un certificato in scadenza) non nasconde nulla: il dispositivo risponde ancora, e anche ciò che sta dietro. Il genitore mantiene il proprio avviso e la propria notifica; quando si riprende, i figli ancora fuori servizio si attivano e notificano da soli.
Lo stesso vale per un monitor irraggiungibile stesso: i suoi altri avvisi
(disco pieno, CPU, ecc.) vengono soppressi dal suo stesso guasto, con
suppressed_by che nomina il monitor stesso, perché i loro valori non sono
più aggiornati e sono solo un sintomo dello stesso guasto. Solo il suo avviso
“Monitor unreachable” non viene mai nascosto dal proprio guasto, quindi vieni
avvisato una volta.
Imposta il genitore nel modulo del monitor. Nella pagina Devices, i figli si impilano sotto il loro genitore e si attenuano quando è fuori servizio.
Un agent relay conta come genitore di ogni monitor che sonda (Reached through nel modulo del monitor), in aggiunta al genitore impostato esplicitamente: quando il relay è fuori servizio, i suoi monitor vengono soppressi con il relay nominato come causa. A pari distanza, il genitore esplicito vince.
Un genitore conta anche come fuori servizio non appena la sua propria sonda lo dice (lo stato Timed out, Monitor unreachable o Servizio non disponibile sulla sua pagina), senza attendere che il suo avviso si attivi: un agent che smette di inviare porta con sé i suoi monitor un minuto o due prima del suo proprio avviso, e uno switch il cui ping è appena fallito nasconde i suoi figli prima che l’attesa di “Servizio non disponibile” sia trascorsa; altrimenti ognuno di essi notificherebbe prima.
Raggruppamento, deduplicazione, ricordi
Sezione intitolata “Raggruppamento, deduplicazione, ricordi”Senza raggruppamento, un NAS il cui RAID si degrada invierebbe un
messaggio per disco, per ciclo. DumbMonit invia al massimo un messaggio
per host e per ciclo, anche se contiene cinque righe. Ogni avviso viene
notificato una volta quando inizia ad attivarsi (firing), poi solo come
un ricordo (reminder, ogni repeat_interval), un’escalation
(escalation) o una risoluzione (resolved). La cronologia degli
avvisi registra ogni transizione con se è stata notificata e, se no,
perché (apprendimento, soppresso, silenziato, confermato).
Finestre di manutenzione
Sezione intitolata “Finestre di manutenzione”Un silenzio interrompe le notifiche senza interrompere la valutazione: alla fine di una finestra, un avviso ancora attivo viene notificato una volta, invece di “nascere” dopo due ore di esistenza. Le finestre sono puntuali o settimanali, per monitor o per l’intera istanza. Vedi Finestre di manutenzione.
Apprendimento della baseline
Sezione intitolata “Apprendimento della baseline”La regola “Unusual CPU” non richiede alcuna soglia. Per ogni serie
mantiene 168 bucket, uno per (giorno della settimana, ora), e confronta
ogni punto con ciò che viene solitamente osservato in quel momento. Il
punteggio è robusto (mediana e MAD, un EWMA per bucket con alpha = 0.05), così un singolo incidente non riscrive la baseline, e le derive
stagionali vengono seguite.
La regola resta silenziosa per i suoi primi quattordici giorni di apprendimento: ogni bucket deve essere stato visto almeno due volte per distinguere “inusuale” da “mai osservato”. Nel frattempo viene mostrata con un flag learning e dice solo cosa si sarebbe attivato. Le baseline di serie scomparse vengono scordate dopo 60 giorni.
Previsioni
Sezione intitolata “Previsioni”Due tipi di avviso prevedono invece di segnalare, e la panoramica li
elenca sotto Forecasts: l’anomalia di baseline, e le regole predict
che estrapolano una serie con predict_linear() sul lato VictoriaMetrics
(“Filesystem almost full” entro quattro giorni). La stima del datastore
PBS è una semplice soglia sulla previsione propria di PBS.
Dove vanno le notifiche
Sezione intitolata “Dove vanno le notifiche”Le regole integrate non hanno alcun canale collegato, il che significa ogni canale abilitato. Una regola che modifichi può nominare canali specifici. I canali vengono configurati in Settings → Notifications & reports; vedi Canali di notifica.
Notifiche intelligenti
Sezione intitolata “Notifiche intelligenti”Tutto quanto sopra decide se un avviso può parlare. Una seconda fase, la politica di notifica, decide quando e su quale canale, così che nessuno venga sommerso di messaggi. Il percorso completo di un avviso, in ordine:
- Valutare — soglia, punteggio di anomalia o previsione, con
l’attesa della regola (
for) e, quando impostata, la sua soglia di azzeramento (isteresi: si attiva sopra il 90%, si azzera solo sotto l’85%) e qualsiasi override per monitor. - Deduplicare — un’impronta per (regola, serie), basata sull’id del
monitor (
target) invece che sul suo nome: rinominare un monitor o modificare i suoi tag non crea un secondo avviso, e una serie che si risolve nella stessa chiave due volte produce un unico avviso. Le serie di un monitor eliminato o messo in pausa vengono scartate: i loro avvisi si azzerano all’istante, senza alcuna notifica, e la cronologia registradevice removed or disabled. - Sopprimere per dipendenza — i discendenti di un monitor fuori servizio restano silenziosi.
- Silenziare — le finestre di manutenzione zittiscono ciò che coprono.
- Raggruppare per monitor — un messaggio per monitor per ciclo, ricordi ed escalation inclusi.
- Attesa di flapping — un’impronta che si attiva e si azzera 4 volte in 30 minuti invia un unico avviso di “flapping”, poi nulla per 30 minuti.
- Filtri per canale — severità minima, “dimmi quando si risolve” attivo/disattivo, e un intervallo minimo tra due messaggi sullo stesso avviso.
- Ore silenziose (per canale) — solo gli avvisi di livello Warning passano; il resto attende un digest quando le ore silenziose terminano (un avviso che si azzera nel frattempo viene solo menzionato come “resolved during quiet hours”).
- Batching — gli avvisi entro la finestra di batch (60 s per impostazione predefinita) uscono come un messaggio per canale: “3 alerts on 2 devices, 1 resolved”.
- Limite orario — oltre
max_per_hourmessaggi su un canale, gli avvisi attendono e arrivano come un digest (“…and 7 more alerts”). - Inviare — con un link “Open in DumbMonit” per monitor quando un URL pubblico è conosciuto.
I passaggi 6 a 10 sono configurati in Settings → Notifications & reports → Notification policy (globale) e su ogni canale (Delivery options). Vedi Politica di notifica.